


Da die Nachfrage nach skalierbarem, fehlertolerantem Speicher wächst, wenden sich viele Organisationen Open-Source-Plattformen wie Ceph und MinIO zu. Beide Systeme unterstützen Erasure Coding (EC) – eine Methode zur Erzielung von Datenbeständigkeit mit geringerem Speicher-Overhead als bei herkömmlicher Replikation – und beide sind in Cloud- und Unternehmensumgebungen weit verbreitet.
Die beiden Projekte unterscheiden sich jedoch erheblich in ihrer Designphilosophie, ihrem operativen Fußabdruck und ihrem Anwendungsfokus. Diese Unterschiede spielen eine entscheidende Rolle dabei, wie jede Plattform in der Produktion Leistung erbringt, skaliert und Ressourcen verbraucht. Da architektonische Entscheidungen die Implementierung von Funktionen wie Erasure Coding und Metadatenverwaltung untermauern, beginnen wir mit einem Überblick über das interne Design jeder Plattform.
Architektonisches Design und Komplexität
Das interne Design einer Speicherplattform bestimmt, wie effizient sie Daten verwalten, Arbeitslasten verteilen und sich von Ausfällen erholen kann. Architektonische Entscheidungen beeinflussen auch direkt, wie viel Rechenleistung und Speicher benötigt werden, um das System am Laufen zu halten.
Ceph ist eine allgemeine verteilte Speicherplattform, die Objekt-, Block- und Dateispeicher unterstützt. Ihre Architektur umfasst mehrere Subsysteme:
- Ceph OSD-Daemons verwalten Objektspeicher auf der Festplatte,
- MON (Monitor)-Knoten verwalten Cluster-Quorum und Metadaten,
- MGR (Manager)-Daemons stellen Metriken und Orchestrierung bereit,
- MDS (Metadatenserver) sind für die Dateispeicherung über CephFS erforderlich.
Dieses geschichtete Design verleiht Ceph erhebliche Flexibilität, führt aber zu operativer Komplexität. Jede Komponente verbraucht Systemressourcen und erhöht den Netzwerk- und Koordinations-Overhead.
MinIO hingegen ist ein spezialisiertes Objektspeichersystem, das leichtgewichtig und performant sein soll. Es wird als einzelnes Binary bereitgestellt und unterstützt die S3-API nativ. Es bietet keinen Block- oder POSIX-Dateispeicher. Seine Architektur ist minimal und konzentriert sich auf Skalierbarkeit durch horizontale Verteilung, ohne dass separate Control-Plane-Daemons erforderlich sind.
Diese architektonischen Entscheidungen beeinflussen nicht nur Leistung und Skalierbarkeit, sondern bestimmen auch, wie Datenschutzmechanismen wie Erasure Coding implementiert und verwaltet werden. Der folgende Abschnitt untersucht, wie sich Ceph und MinIO in ihrem Ansatz zum Erasure Coding unterscheiden – einer Kernfunktion zur Gewährleistung der Ausfallsicherheit in verteilten Speichersystemen.
Ansätze für Erasure Coding
Erasure Coding (EC) ist eine Datenschutztechnik, die in modernen Speichersystemen verwendet wird. Anstatt vollständige Replikate zu kopieren, teilt EC Daten in Fragmente auf, fügt Paritätsblöcke hinzu und verteilt sie auf Knoten. Dies bietet Ausfallsicherheit mit geringerem Speicher-Overhead – aber die Art und Weise, wie EC implementiert wird, beeinflusst Leistung, Wiederherstellungsgeschwindigkeit sowie CPU- und Speichernutzung.
Beide Speicherlösungen verwenden Erasure Coding, um die Datenbeständigkeit zu erhöhen und gleichzeitig den Speicher-Overhead zu minimieren, aber ihre Implementierungen sind recht unterschiedlich.
Cephs Erasure Coding ist in die RADOS-Schicht integriert und eng mit seinen Objektverwaltungs- und Replikationsmechanismen gekoppelt. Ceph ermöglicht Administratoren die Definition von EC-Profilen mit verschiedenen Daten-/Paritätskonfigurationen und unterstützt fein abgestufte Datenplatzierungsrichtlinien über CRUSH-Maps.
Während dies den Betreibern Kontrolle über Datenlayout und Fehlerdomänen gibt, erhöht es die Metadatenverarbeitung und Koordination zwischen den Knoten, insbesondere während der Wiederherstellung oder des Rebalancings. MinIOs Erasure Coding ist für Streaming- und durchsatzorientierte Arbeitslasten konzipiert. Es arbeitet im Einklang mit I/O-Operationen und minimiert Metadaten-Lookups. Jeder Knoten kennt die EC-Konfiguration, und Daten werden gleichmäßig über alle Laufwerke und Knoten verteilt.
Datenintegrität und Scrubbing
Über Erasure Coding hinaus unterscheiden sich auch die Mechanismen zur Datenintegrität. Ceph beinhaltet einen Scrubbing-Prozess, der gespeicherte Daten aktiv scannt, um Bit-Rot oder stille Korruption zu erkennen und zu reparieren. Dieser Hintergrundvorgang gewährleistet langfristige Ausfallsicherheit, insbesondere in großen oder alternden Clustern.
MinIO hingegen führt kein aktives Scrubbing durch. Es verlässt sich ausschließlich auf Erasure Coding und Pro-Objekt-Prüfsummen während Lese-/Schreibvorgängen. Während dies für viele Arbeitslasten ausreichenden Schutz bietet, werden latente Fehler möglicherweise nicht erkannt, es sei denn, die betroffenen Objekte werden aufgerufen.
Metadatenverwaltung
Metadaten in Speichersystemen umfassen Informationen darüber, wo Daten gespeichert sind, wie sie geschützt werden, wann sie geschrieben wurden und mehr. Eine effiziente Metadatenverwaltung ist entscheidend für Leistung und Skalierbarkeit, insbesondere wenn das Datenvolumen wächst.
MinIO speichert Objektmetadaten direkt im Dateisystem neben den Objektdaten. Dies reduziert die Komplexität und den I/O-Overhead, schränkt jedoch einige erweiterte Metadatenfunktionen ein. Ceph speichert Objektmetadaten in dedizierten MON-Knoten und Objekt-Maps, was erweiterte Funktionen wie benutzerdefinierte Datenplatzierung und detailliertes Monitoring ermöglicht – auf Kosten erhöhter Speicher- und Arbeitsspeicheranforderungen.
Hardware-Ressourcenvergleich: ein praktisches Beispiel
Speicherinfrastrukturteams müssen die Kapazität nicht nur in Terabyte planen, sondern auch im Hinblick auf die benötigte Hardware – einschließlich Festplatten, CPU, RAM und Netzwerk. Architektonische Unterschiede und Unterschiede beim Erasure Coding führen zu erheblichen Abweichungen im Bedarf an Rohkapazität und Rechenleistung.
Um zu verstehen, wie sich die Architektur in Hardwareanforderungen übersetzt, betrachten Sie die folgende Dimensionierung für einen Cluster, der 1 PB nutzbaren Speicher unter Verwendung von Erasure Coding anstrebt.
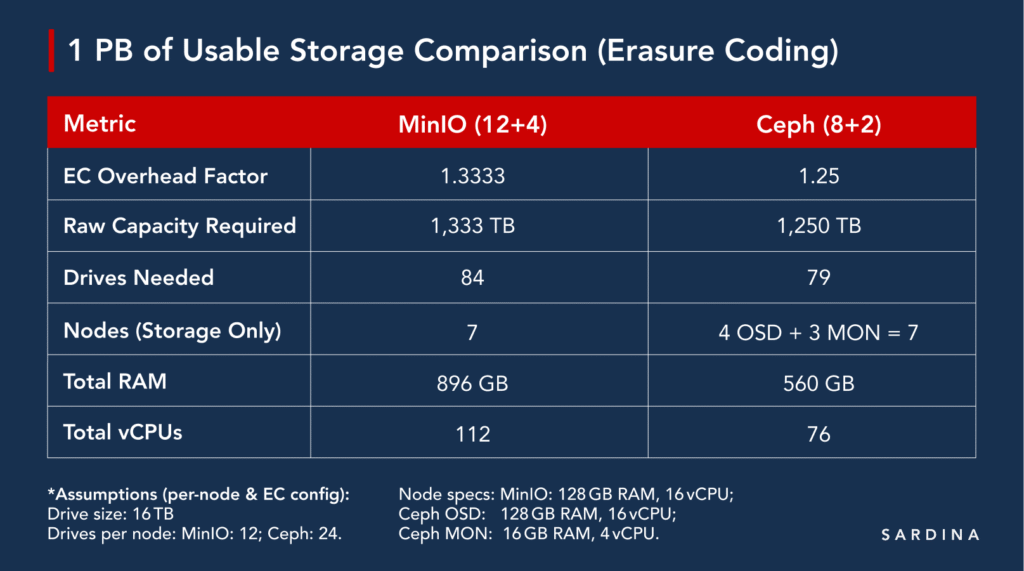
Während MinIO in diesem Beispiel etwas mehr Rohkapazität und insgesamt mehr CPU/RAM benötigt, sind diese Zahlen empfindlich gegenüber EC-Profilen, Laufwerksgröße und Serverdichte.
Cephs Konfiguration geht von separaten Monitor-Knoten aus. MinIOs Design erfordert keine dedizierten Control-Plane-Dienste, was in einigen Szenarien das Cluster-Design vereinfachen und den Verwaltungsaufwand reduzieren kann.
Anwendungsfälle und Kompromisse
Die Wahl zwischen Ceph und MinIO hängt stark vom Anwendungsfall, der Teamexpertise und den Infrastrukturzielen ab. Objektspeicher für Analyse-Pipelines hat sehr unterschiedliche Anforderungen als Multi-Protokoll-Speicher für VM-Umgebungen.

Lizenzierung und Quellcodezugriff
Sowohl Ceph als auch MinIO sind Open-Source, folgen aber unterschiedlichen Lizenzmodellen, was die Bereitstellungsstrategie beeinflussen kann, insbesondere für die kommerzielle Nutzung oder SaaS-Anbieter.
Ceph ist unter LGPLv2.1 lizenziert und bietet vollen Quellcodezugriff ohne kommerzielle Einschränkungen. Es wird häufig in Unternehmens- und Cloud-Umgebungen eingesetzt, einschließlich kommerzieller Produkte. Mit FishOS Ceph können Organisationen auch eine kommerzielle Lizenz wählen, um Expertenunterstützung sowie zusätzliche Entwicklungen und Funktionen zu erhalten. MinIO verwendet AGPLv3, eine restriktivere Lizenz, die die Offenlegung des Codes erfordert, wenn er zur Bereitstellung von Diensten über ein Netzwerk verwendet wird. Die kommerzielle Nutzung, insbesondere bei SaaS-Angeboten, kann eine separate kommerzielle Lizenz von MinIO, Inc. erfordern.

Die Wahl zwischen MinIO und Ceph hängt weniger davon ab, was „besser“ ist, sondern vielmehr davon, was Ihre Arbeitslast und Teamstruktur erfordern.
- Ceph eignet sich für Organisationen, die eine einheitliche, multiprotokollfähige Speicherschicht mit tiefen Integrationen und erweiterter Kontrolle suchen.
- MinIO ist besser geeignet für objektbasierte Arbeitslasten, insbesondere dort, wo Einfachheit, Leistung und Cloud-native Kompatibilität Priorität haben.
Die Art und Weise, wie jedes System Erasure Coding, Metadaten, Scrubbing und Orchestrierung handhabt, beeinflusst nicht nur den reinen Hardwarebedarf, sondern auch den operativen Aufwand und die Systemkomplexität.
Bevor Sie sich entscheiden, ist es wichtig, Ihre Speicheranforderungen zu modellieren, Ihr Erasure-Coding-Profil zu verstehen und die operativen Kompromisse zu bewerten – insbesondere im Hinblick auf Cluster-Management, Leistungsoptimierung und Lizenzpflichten.