


Entdecken Sie, wie Sie Ihre Cloud-Infrastruktur für KI-Workloads umgestalten können: von Kosten- bis Ressourceneinsparungen.
Dies ist eine Kopie eines Artikels, der auf Spiceworks veröffentlicht wurde. Klicken Sie hier, um die Originalversion zu lesen.
Kenneth Tan, PhD, Executive Director und mehrsprachiger Technologieführer von Sardina Systems, geht auf die wachsende Notwendigkeit für Unternehmen ein, KI geschickt in ihre Abläufe zu integrieren. Er bietet strategische Einblicke in den Aufbau einer robusten KI-Infrastruktur, um ihr volles Potenzial für geschäftliche Innovation und Effizienz zu erschließen.
In den letzten Jahren hat die rasante Ausbreitung der künstlichen Intelligenz (KI) die Geschäftswelt revolutioniert und eine Nachfrage nach KI-Fähigkeiten geschaffen, die oft über bestehende Unternehmensstrategien hinausgehen. Dies hat Unternehmen dazu veranlasst, nach effektiven Wegen zur Integration von KI in ihre Abläufe zu suchen.
Wie und wo sollte man mit der KI-Infrastruktur beginnen und sich auf eine langfristige Strategie konzentrieren, um das Potenzial der KI zu maximieren?
Unternehmen automatisieren zunehmend Abteilungen mit KI und integrieren neue KI-Funktionen in ihre Anwendungen. Trotz der zunehmenden Akzeptanz von KI, die in einer Studie von McKinsey hervorgehoben wird, die einen signifikanten Anstieg seit 2017 zeigt, beschränkt sich die Anwendung von KI-Tools noch weitgehend auf die persönliche Nutzung und die Optimierung der täglichen Routine.
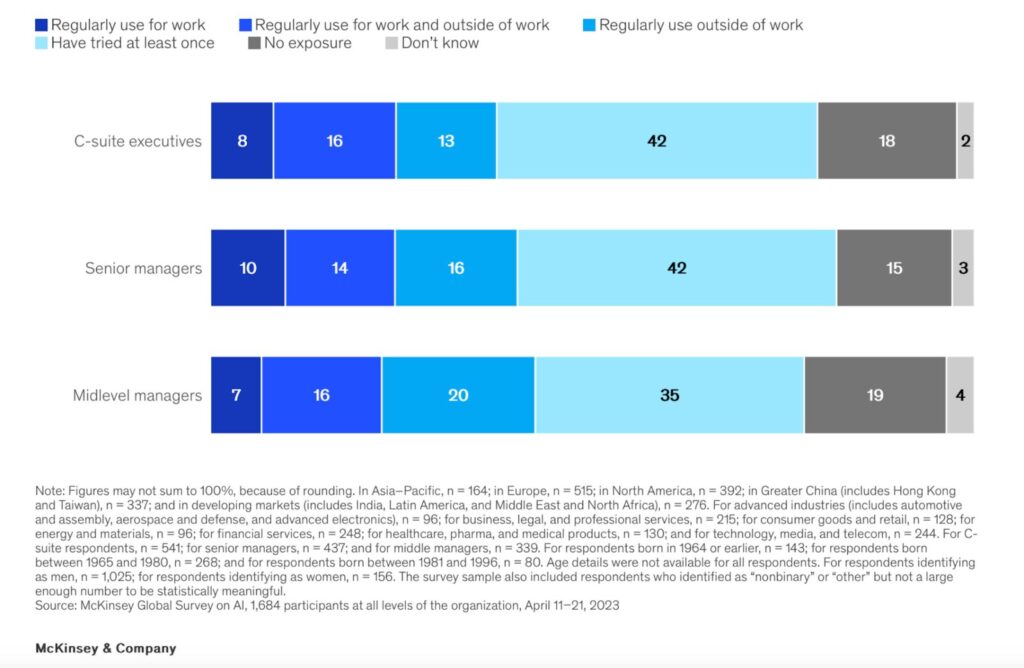
Gleichzeitig entwickelt sich KI schnell auf Unternehmensebene. Unsere Kunden, darunter solche, die KI als Dienstleistung anbieten und solche, die KI in ihre Produkte einbetten, verdeutlichen die Nachfrage des Marktes nach einfach zu integrierenden KI-Tools und der Entwicklung innovativer Dienstleistungen, wie z.B. die Bereitstellung von Zugang zu Rechenressourcen für Forscher.
Dieser Artikel richtet sich sowohl an Dienstleistungsanbieter als auch an Produktintegratoren und unterstreicht die Bedeutung einer gut geplanten, skalierbaren IT-Infrastruktur, um unnötige Ausgaben und Veralterung aufgrund sich schnell entwickelnder Technologien zu vermeiden. Um den Weg zur Integration von KI-Infrastrukturen zu beschreiten, müssen Sie die aktuellen Möglichkeiten kennen und strategisch für den zukünftigen Bedarf planen. Wir skizzieren fünf wesentliche Schritte, um diesen Prozess effektiv zu steuern.
1. Bewertung der aktuellen Infrastruktur
Ein strategischer Ansatz für die Cloud und die gesamte IT-Infrastruktur ist unabdingbar.
Veränderungen, vor allem in der IT-Kerninfrastruktur, erfordern eine umfassende Bewertung des Geschäftsmodells und der zu erwartenden Arbeitslasten, vielleicht schon Jahre im Voraus, was die entscheidende Bedeutung einer sorgfältigen Planung in der Ära der KI unterstreicht.
Der erste Schritt bei dieser Umstellung besteht in einer gründlichen Bewertung der aktuellen IT-Infrastruktur, bei der Stärken, Schwächen und Lücken in Bezug auf die KI-Anforderungen ermittelt werden.
Diese Bewertung sollte die Hardware (z.B. Server, Speicher, Netzwerke), die Software (z.B. Datenbanken, Anwendungsplattformen) und die bestehenden Datenverwaltungspraktiken umfassen.
Das Verständnis des aktuellen Zustands der IT-Infrastruktur ist für die Planung notwendiger Upgrades oder Änderungen für die Einführung von KI unerlässlich.
Verschiedene Konzepte und Frameworks helfen Unternehmen traditionell bei der Bewertung ihrer IT-Infrastruktur.
Die Verwendung solcher Methoden kann strukturierte Ansätze für die Bewertung der Effektivität, Effizienz, Sicherheit und Ausrichtung der IT-Systeme auf die Unternehmensziele bieten:
- Unter den klassischen Methoden ist ITIL (Information Technology Infrastructure Library) besonders relevant, da die Integration von KI eng mit der Geschäftsstrategie abgestimmt werden sollte. ITIL wurde von der britischen Regierung entwickelt und wird regelmäßig aktualisiert. Es bietet ein detailliertes Rahmenwerk für das IT-Service-Management, um IT-Services mit den Geschäftsanforderungen in Einklang zu bringen, und deckt die Entwicklung und Verbesserung von Services ab. Es fördert einen flexiblen Ansatz für das IT-Management, wobei ITIL 4 erhebliche Fortschritte bringt. Die Integration von Management und Technologie ist von entscheidender Bedeutung. Ein rein technischer Fokus kann breitere Auswirkungen verpassen, insbesondere bei der Integration von KI.
- Ein weiteres relevantes Dokument ist COBIT von der Information Systems Audit and Control Association, das ein umfassendes Rahmenwerk für die IT-Verwaltung und -Governance in Unternehmen bietet und die Ausrichtung an den Geschäftszielen, das Risikomanagement und die Leistungsoptimierung gewährleistet. Die Verwendung von COBIT stellt sicher, dass IT-Upgrades die Effizienz steigern und mit den besten Praktiken für Automatisierung und Management in Einklang stehen.
2. Rechenleistung und Hochleistungsprozessoren
KI und insbesondere Deep Learning erfordern Prozessoren mit erheblichen Rechenkapazitäten, wie z.B. Graphics Processing Units (GPUs), Tensor Processing Units (TPUs) oder Field-Programmable Gate Arrays (FPGAs).
Der Hardwaremarkt entwickelt sich ständig weiter, und weltweit tauchen neue Prozessoren und Beschleuniger für KI auf.
Eine dieser jüngsten Innovationen ist der Gaudi3-Prozessor.
Es mag zwar verfrüht sein, neue Produkte vorschnell zu übernehmen, aber es ist zweifellos wichtig, den Markt genau zu beobachten, über neue Lösungen informiert zu bleiben und diesen Sektor gründlich zu erkunden.
Zu den wichtigsten Fragen, die Sie sich stellen sollten, gehören, wie sich diese neuen Angebote qualitativ unterscheiden, welche Software eine solche Infrastruktur unterstützen kann und ob die neuen Lösungen die aktuellen Herausforderungen Ihres Systems bewältigen können.
GPUs sind heute die beliebteste Wahl, da sie weithin kommerziell verfügbar sind und eine hohe Leistung bieten.
Bei der Auswahl eines Grafikprozessors für die KI-Infrastruktur ist es wichtig, die spezifischen Anforderungen Ihrer Arbeitslast zu berücksichtigen.
Dazu gehört die Entscheidung, ob der Schwerpunkt auf Training oder Inferenz liegt, die Beurteilung der Größe und Komplexität Ihrer Modelle, die Berücksichtigung von Budgetbeschränkungen und die Evaluierung des Software-Ökosystems.
Die GPUs von NVIDIA, insbesondere die A100, H100 oder H200, sind in der Branche aufgrund ihrer Leistung, der umfassenden Softwareunterstützung und der speziellen KI-Beschleunigungsfunktionen sehr beliebt.
Dennoch werden AMD und Intel immer mehr zu echten Alternativen, vor allem in Szenarien, in denen ihre einzigartigen Funktionen oder ihre Kosteneffizienz klare Vorteile bieten.
Eine weitere wichtige Überlegung ist die Fähigkeit, die Ressourcen entsprechend den Anforderungen der Arbeitslast zu skalieren.
Diese Skalierbarkeit ist entscheidend für die Kostenkontrolle und die Aufrechterhaltung der Effizienz in den verschiedenen Phasen der Entwicklung und Bereitstellung von KI-Modellen.
Um die entscheidende Rolle der Skalierbarkeit bei KI-Operationen zu veranschaulichen, betrachten Sie die regelmäßige saisonale Nachfrage, mit der die großen E-Commerce-Plattformen konfrontiert sind.
Amazon nutzt KI, um verschiedene Aspekte seines Betriebs zu optimieren, darunter Bestandsmanagement, personalisierte Empfehlungen und Logistik.
Während der Haupteinkaufszeiten wie dem Black Friday oder dem Cyber Monday steigt die Nachfrage nach den Systemen von Amazon dramatisch an.
Um dies zu bewältigen, nutzt Amazon Cloud Computing-Plattformen, die eine dynamische Skalierung der Ressourcen ermöglichen.
Diese Skalierbarkeit ist entscheidend für die Bewältigung des zunehmenden Datenverkehrs und das Kostenmanagement.
Indem die Ressourcen nur bei Bedarf aufgestockt und bei nachlassender Nachfrage zurückgefahren werden, kann Amazon die Kosten effizient verwalten, ohne die Leistung zu beeinträchtigen.
Dieser Ansatz stellt sicher, dass die Infrastruktur in Schwachlastzeiten nicht unter- und in Hochlastzeiten nicht überlastet wird. So wird ein optimales Gleichgewicht aufrechterhalten, das kontinuierliche KI-getriebene Innovation und Kundenzufriedenheit unterstützt.
3. Hochvolumige Speicherung und Verwaltung
KI-Systeme benötigen die Fähigkeit, große Datenmengen zu speichern und zu verwalten.
Dies erfordert schnelle, skalierbare Speicherlösungen, wie Objektspeicher für unstrukturierte Daten und Hochleistungsdatenbanken für strukturierte Daten.
Ein schneller und zuverlässiger Zugriff auf diese Daten ist für das effektive Training von KI-Modellen unabdingbar.
Um dies zu erreichen, müssen Sie fortschrittliches Daten-Caching nutzen, Netzwerke mit hoher Bandbreite einsetzen und effiziente Datenabrufsysteme implementieren.
Ceph als Speicherlösung ist ein Beispiel für Flexibilität und Effizienz bei der Handhabung großer Datenmengen.
Sie gewährleistet die Kompatibilität mit bestehenden Anwendungen und erleichtert die Integration mit Cloud-Plattformen, was sie zu einer kostengünstigen Lösung macht.
Darüber hinaus reduziert Ceph die mit der Speicherung von Unternehmensdaten verbundenen Kosten erheblich und unterstützt Unternehmen bei der Verwaltung des exponentiellen Datenwachstums. Da Ceph auf handelsüblicher Server-Hardware läuft, kann es durch seine Selbstverwaltungs- und Selbstheilungsfunktionen die Investitionsausgaben (CapEx) und die Betriebsausgaben (OpEx) senken.
Eine alternative Möglichkeit, Massendatenspeicher und hohe Kapazitäten effizient bereitzustellen, ist die Verwendung von NVMe over Fabrics (NVMe-oF). Dabei handelt es sich nicht um ein Produkt eines einzelnen Herstellers, sondern um einen Standard, den verschiedene Unternehmen für ihre Produkte und Lösungen nutzen können.
NVMe over Fabrics (NVMe-oF) kann den Aufbau leistungsfähiger und kosteneffizienter Datenspeichersysteme erheblich unterstützen, insbesondere wenn hohe Leistung und Skalierbarkeit erforderlich sind. NVMe-oF nutzt die Vorteile von NVMe SSDs wie niedrige Latenzzeiten und hohe Datenübertragungsgeschwindigkeiten über Netzwerkverbindungen. Dadurch können entfernte Systeme fast so schnell auf Daten zugreifen, als wären die Speichergeräte lokal über PCIe angeschlossen. Dies ist ideal für Anwendungen mit hohem Bedarf wie Datenbanken, große Rechenlasten und Big Data-Verarbeitung in Echtzeit.
Ein weiterer Vorteil ist die einfache Skalierung von Speichersystemen durch Hinzufügen weiterer NVMe-Geräte zum Netzwerk ohne Leistungseinbußen, so dass Unternehmen wachsende Anforderungen an die Datenspeicherung erfüllen können, ohne ihre Infrastruktur komplett zu überholen.
Obwohl NVMe-Geräte teurer sein können als herkömmliche SATA-SSDs oder HDDs, kann die Verwendung von NVMe-oF effizientere und schnellere Speichersysteme schaffen.
Einsparungen werden durch eine bessere Leistung pro Gerät erzielt, was die Gesamtzahl der benötigten Geräte reduzieren und die Wartungs- und Energiekosten senken kann.
4. Anbieter von Software und Cloud-Plattformen
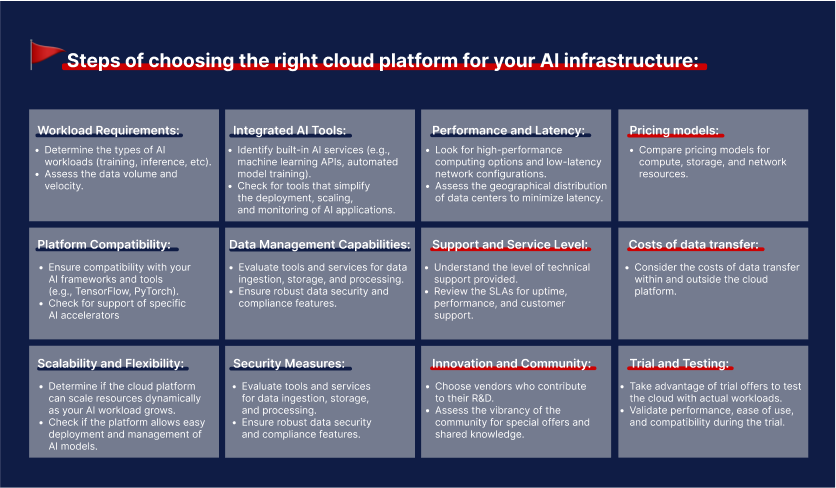
Die Wahl der richtigen Cloud-Plattform oder des richtigen Anbieters ist eine wichtige Entscheidung für die KI-Infrastruktur. Die meisten Cloud-Plattformen sind zwar in der Lage, KI-Arbeitslasten zu unterstützen, aber die wichtigste Überlegung sollte die Kompatibilität mit dem für Ihr System ausgewählten Prozessor sein. Damit eine Infrastruktur wirklich effektiv ist, reicht dies allein jedoch nicht aus.
Das Fachwissen des KI-Infrastrukturteams ist entscheidend für eine optimale Leistung.
Obwohl die Cloud-Virtualisierung weit verbreitet ist, ist sie nicht immer die beste Lösung für KI-Systeme.
Ein Hybridmodell aus Cloud, Virtualisierung und Bare Metal, wie in einem Fall gezeigt, kann die Anforderungen von Deep Learning effektiv erfüllen, indem es die Verteilung der Rechenleistung mit einem leistungsstarken Bare-Metal-Zugang verbindet.
Daher ist es für Anbieter entscheidend, die Ziele des Systems genau zu verstehen, um die effektivste Cloud-Technologie-Lösung zu finden.
Eines der Finanzunternehmen, JPMorgan Chase, stand vor der Herausforderung, riesige Datenmengen für Echtzeit-Finanzanalysen und Risikomanagement zu verarbeiten.
JPMorgan Chase erkannte die Grenzen der traditionellen Cloud-Virtualisierung für seine spezifischen KI-Arbeitslasten und entschied sich für eine hybride Cloud-Infrastruktur, die Cloud-, Virtualisierungs- und Bare-Metal-Lösungen kombiniert.
Dieses hybride Modell ermöglicht es JPMorgan Chase, die Flexibilität der Cloud und der Virtualisierung für Skalierbarkeit und Kosteneffizienz zu nutzen und gleichzeitig die Leistung von Bare-Metal-Servern für rechenintensive KI-Aufgaben zu verwenden.
Die Bare-Metal-Server bieten direkten Zugriff auf Hardware-Ressourcen und umgehen den mit der Virtualisierung verbundenen Overhead. Dies ist entscheidend für die leistungsintensiven Anforderungen von Deep-Learning-Algorithmen, die bei der Finanzmodellierung und Risikobewertung eingesetzt werden.
Die Infrastruktur muss flexibel genug sein, um sich an die sich entwickelnden KI-Anforderungen anzupassen. Sie muss die Einbindung neuer Technologien und die Anpassung oder Erweiterung von Ressourcen bei minimaler Unterbrechung ermöglichen.
Viele Cloud-Anbieter bieten KI- und maschinelle Lerndienste an, die in die KI-Infrastruktur integriert werden können und Zugang zu leistungsstarken Tools für die Modellentwicklung, das Training und den Einsatz bieten.
Technologien wie OpenStack für die Virtualisierung und Kubernetes für die Containerisierung spielen eine wichtige Rolle bei der Verwaltung von KI-Anwendungen.
Sie vereinfachen die Bereitstellung, die Skalierung und den Betrieb von KI-Workloads in verschiedenen Umgebungen und verbessern die Agilität der Infrastruktur und die Reaktionsfähigkeit auf wechselnde Anforderungen.
5. Energieeffizienz und Verbrauch
Die Integration von KI in die IT-Infrastruktur steigert die Möglichkeiten der Datenverarbeitung und der Ausführung von Algorithmen, wirft aber auch Fragen des Energieverbrauchs auf, insbesondere bei Deep-Learning-Modellen, die eine erhebliche Rechenleistung benötigen. Der Energieaspekt ist die größte Herausforderung, denn die herkömmliche Strategie zur Verbesserung der Energieeffizienz besteht darin, Lasten umzuverteilen und ungenutzte Kapazitäten abzuschalten.
Im Zusammenhang mit der KI kann das Abschalten von Maschinen jedoch eine besondere Herausforderung darstellen und die Energieeffizienz nur geringfügig verbessern.
Daher ist es ratsam, sich auf den Ausgleich der Leistung zu konzentrieren und die Komponenten der Infrastruktur zu identifizieren und zu verwalten, die am meisten Energie verbrauchen.
In der KI-Infrastruktur handelt es sich dabei typischerweise um GPUs, FPGAs und andere Hardwarekomponenten, die eine kontinuierliche Kühlung oder Wärmeableitung erfordern.
Wenn sich die direkte Optimierung des Energieverbrauchs als schwierig erweist, können durch die Verbesserung der Effizienz der Kühlsysteme immer noch erhebliche Einsparungen erzielt werden.
Rechenzentren in Island, wie Borealis oder atNorth, veranschaulichen einen effektiven Ansatz für das Energiemanagement.
Diese Rechenzentren nutzen das kühle Klima Islands und die reichlich vorhandenen erneuerbaren Energiequellen, um die natürliche Kühlung und die geothermische Energie zu nutzen. Dadurch wird der Bedarf an künstlicher Kühlung erheblich reduziert und der Gesamtenergieverbrauch von KI-Infrastrukturen gesenkt.
Der Betrieb in Island bringt jedoch auch Herausforderungen mit sich, insbesondere in Bezug auf Netzwerklatenz und Konnektivität aufgrund der abgelegenen Lage.
Daher ist es ratsam, die Art der Arbeitslasten und den Zeitpunkt der in diesen Rechenzentren durchgeführten Projekte sorgfältig auszuwählen.
Arbeitslasten, die weniger empfindlich auf Latenzzeiten reagieren, oder solche, die außerhalb der Spitzenzeiten geplant werden können, können sowohl den Energieverbrauch als auch die Netzwerkleistung optimieren und so das Beste aus der einzigartigen Umgebung Islands herausholen und gleichzeitig mögliche Nachteile abmildern.
Dieser strategische Ansatz unterstreicht die Bedeutung einer durchdachten Infrastrukturplanung für die Maximierung von Leistung und Energieeffizienz im KI-Betrieb.
Eine weitere Möglichkeit, die Energieeffizienz zu verbessern, sind energieeffiziente GPUs und TPUs sowie die Optimierung von KI-Algorithmen durch Modellbeschneidung und Quantisierung, die der Schlüssel zur Reduzierung des Energieverbrauchs bei gleichbleibender Leistung sind. Technologische Fortschritte bei Halbleitern und KI-Beschleunigern tragen ebenfalls zur Senkung des Stromverbrauchs bei.

Darüber hinaus verbessern der Einsatz umweltfreundlicher Technologien für Rechenzentren, die Nutzung von Virtualisierung und Cloud Computing sowie die dynamische Skalierung und das KI-gesteuerte Ressourcenmanagement die Energieeffizienz im KI-Betrieb, indem sie die Ressourcennutzung an den Bedarf anpassen. Dies gewährleistet eine effiziente Energienutzung in der gesamten IT-Infrastruktur ohne Leistungseinbußen.
Zusammenfassend lässt sich sagen, dass es für Unternehmen, die Innovationen nutzen und sich einen Wettbewerbsvorteil verschaffen wollen, unerlässlich ist, die IT-Infrastruktur so umzubauen, dass sie KI-fähig ist. Die Priorisierung der Datenverbesserung, die Investition in spezialisierte Hardware, die Integration robuster Cloud-Lösungen, die Sicherung von Netzwerken und der Aufbau eines qualifizierten Teams sind grundlegende Schritte, die die Basis für einen effektiven KI-Einsatz und zukünftige technologische Fortschritte legen. Diese Anstrengungen gewährleisten die erfolgreiche Implementierung von KI und die Flexibilität, sich an neue KI-Fortschritte und Chancen anzupassen.
Wenn Sie fachkundige Unterstützung bei der Umgestaltung Ihrer Cloud-Infrastruktur benötigen, klicken Sie hier, um ein kostenloses Beratungsgespräch mit unserem Team zu vereinbaren. Wir sind immer da, um Unternehmen dabei zu helfen, das Beste aus ihrer Cloud-Infrastruktur zu machen.