


Découvrez comment transformer votre infrastructure cloud pour les charges de travail d’IA : des économies de coûts aux économies de ressources.
Ceci est une copie d’un article publié sur Spiceworks. Cliquez ici pour lire la version originale.
Kenneth Tan, PhD, directeur exécutif et leader technologique multilingue de Sardina Systems, se penche sur la nécessité croissante pour les entreprises d’intégrer habilement l’IA dans leurs opérations, offrant des perspectives stratégiques sur la construction d’une infrastructure d’IA robuste afin de libérer son plein potentiel pour l’innovation et l’efficacité de l’entreprise.
Ces dernières années, l’expansion rapide de l’intelligence artificielle (IA) a révolutionné le monde des affaires, créant une demande de capacités d’IA qui dépassent souvent les stratégies organisationnelles existantes. Cela a conduit les entreprises à rechercher des moyens efficaces d’intégrer l’IA dans leurs opérations.
Comment et où commencer avec l’infrastructure d’IA, en se concentrant sur une stratégie à long terme pour maximiser le potentiel de l’IA ?
Les entreprises automatisent de plus en plus leurs départements grâce à l’IA et intègrent de nouvelles fonctionnalités d’IA dans leurs applications. Malgré la croissance de l’adoption de l’IA, comme le souligne l’étude de McKinsey montrant une augmentation significative depuis 2017, l ‘application des outils d’IA est encore largement relayée par l’utilisation personnelle et l’optimisation de la routine quotidienne.
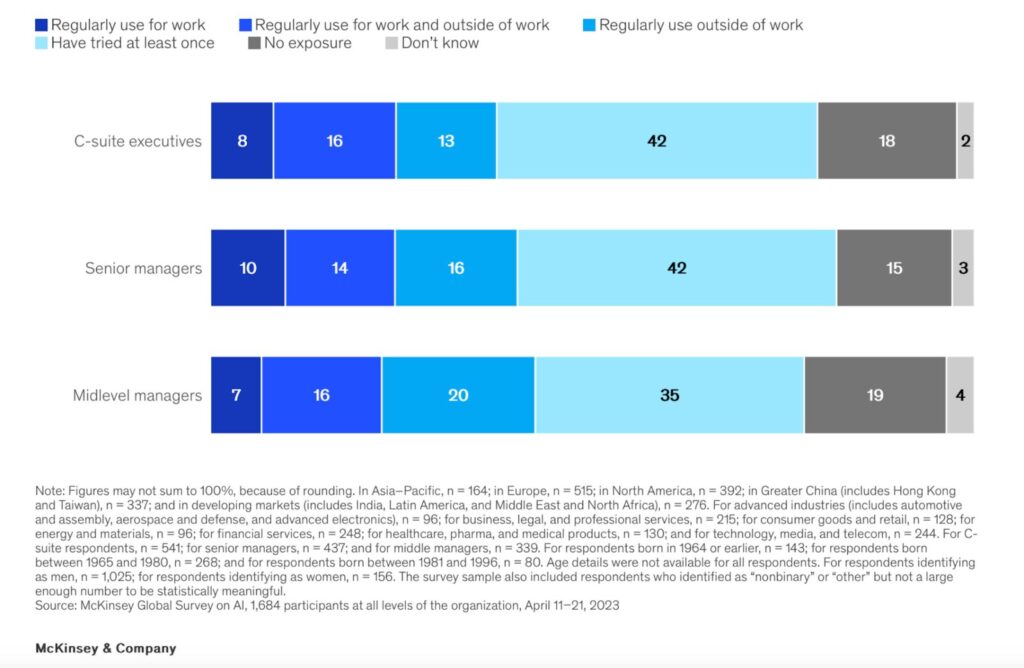
Parallèlement, l’IA se développe rapidement au niveau des entreprises. Nos clients, y compris ceux qui proposent l’IA en tant que service et ceux qui intègrent l’IA dans leurs produits, illustrent la demande du marché pour des outils d’IA facilement intégrables et le développement de services innovants, tels que l’accès des chercheurs à des ressources de calcul.
Cet article s’adresse à la fois aux fournisseurs de services et aux intégrateurs de produits et souligne l’importance d’une infrastructure informatique bien planifiée et évolutive pour éviter les dépenses inutiles et l’obsolescence due à l’évolution rapide des technologies. Pour commencer à intégrer l’infrastructure de l’IA, il faut comprendre les capacités actuelles et planifier stratégiquement les besoins futurs. Nous vous présentons cinq étapes essentielles pour naviguer efficacement dans ce processus.
1. Évaluation de l’infrastructure actuelle
Il est impératif d’adopter une approche stratégique du cloud et de l’infrastructure informatique globale.
Les changements, en particulier l’infrastructure informatique de base, nécessitent une évaluation complète du modèle d’entreprise et des charges de travail prévues, parfois des années à l’avance, ce qui souligne l’importance cruciale d’une planification méticuleuse à l’ère de l’IA.
La première étape de cette transformation consiste à réaliser une évaluation approfondie de l’infrastructure informatique actuelle, en mettant en évidence les forces, les faiblesses et les lacunes concernant les exigences en matière d’IA.
Cette évaluation devrait porter sur le matériel (par exemple, serveurs, stockage, réseaux), les logiciels (par exemple, bases de données, plateformes d’application) et les pratiques existantes en matière de gestion des données.
Il est essentiel de comprendre l’état actuel de l’infrastructure informatique pour planifier les mises à niveau ou les changements nécessaires à l’adoption de l’IA.
Plusieurs concepts et cadres aident traditionnellement les organisations à évaluer leur infrastructure informatique.
L’utilisation de ces méthodologies peut offrir des approches structurées pour évaluer l’efficacité, l’efficience, la sécurité et l’alignement des systèmes informatiques sur les objectifs de l’entreprise :
- Parmi les méthodologies classiques, l’ITIL (Information Technology Infrastructure Library) est particulièrement pertinente, car l’intégration de l’IA doit être étroitement alignée sur la stratégie de l’entreprise. Développée par le gouvernement britannique et régulièrement mise à jour, l’ITIL offre un cadre détaillé pour la gestion des services informatiques afin d’aligner ces derniers sur les besoins de l’entreprise, de la conception des services à leur amélioration. Il encourage une approche flexible de la gestion informatique, ITIL 4 apportant des avancées significatives. L’intégration de la gestion et de la technologie est essentielle ; une simple approche technique peut ne pas avoir d’impact plus large, en particulier en ce qui concerne l’intégration de l’intelligence artificielle.
- Le COBIT, de l’Association pour l’audit et le contrôle des systèmes d’information, est également pertinent. Il fournit un cadre complet pour la gestion et la gouvernance des technologies de l’information dans l’entreprise, en garantissant l’alignement sur les objectifs commerciaux, la gestion des risques et l’optimisation des performances. L’utilisation de COBIT garantit que les mises à niveau informatiques améliorent l’efficacité et sont alignées sur les meilleures pratiques en matière d’automatisation et de gestion.
2. Puissance de calcul et processeurs à haute performance
L’IA, et l’apprentissage profond en particulier, exige des processeurs dotés d’importantes capacités de calcul, tels que les unités de traitement graphique (GPU), les unités de traitement tensoriel (TPU) ou les réseaux de portes programmables sur le terrain (FPGA).
Le marché du matériel informatique est en constante évolution, et de nouveaux processeurs et accélérateurs conçus pour l’IA voient le jour dans le monde entier.
Le processeur Gaudi3 est l’une de ces innovations récentes.
S’il est peut-être prématuré d’adopter de nouveaux produits à la hâte, il est sans aucun doute crucial de suivre le marché de près, de se tenir informé des nouvelles solutions et d’explorer ce secteur en profondeur.
Les principales questions à se poser sont les suivantes : quelles sont les différences qualitatives entre ces nouvelles offres, quels sont les logiciels capables de prendre en charge une telle infrastructure et si les nouvelles solutions peuvent relever les défis actuels auxquels votre système est confronté.
Les GPU sont aujourd’hui le choix le plus populaire en raison de leur grande disponibilité commerciale et de leurs performances élevées.
Lors de la sélection d’un GPU pour une infrastructure d’IA, il est important de prendre en compte les exigences spécifiques de votre charge de travail.
Il s’agit notamment de déterminer si l’accent est mis sur l’entraînement ou l’inférence, d’évaluer la taille et la complexité de vos modèles, de tenir compte des contraintes budgétaires et d’évaluer l’écosystème logiciel.
Les GPU de NVIDIA, en particulier les A100, H100 ou H200, sont très appréciés dans l’industrie pour leurs performances, leur support logiciel complet et leurs fonctions spécialisées d’accélération de l’IA.
Néanmoins, AMD et Intel deviennent des alternatives de plus en plus viables, en particulier dans les scénarios où leurs caractéristiques uniques ou leur rentabilité présentent des avantages évidents.
Une autre considération essentielle est la capacité à faire évoluer les ressources en fonction de la charge de travail.
Cette évolutivité est essentielle pour gérer les coûts et maintenir l’efficacité tout au long des différentes étapes de développement et de déploiement des modèles d’IA.
Pour illustrer le rôle essentiel de l’évolutivité dans les opérations d’IA, considérez la demande saisonnière régulière à laquelle sont confrontées les grandes plateformes de commerce électronique.
Amazon utilise l’IA pour optimiser divers aspects de ses opérations, notamment la gestion des stocks, les recommandations personnalisées et la logistique.
Pendant les périodes de pointe, comme le Vendredi noir ou le Cyber lundi, la demande sur les systèmes d’Amazon augmente considérablement.
Pour y faire face, Amazon s’appuie sur des plateformes d’informatique en nuage qui permettent une mise à l’échelle dynamique des ressources.
Cette évolutivité est essentielle pour faire face à l’augmentation du trafic et gérer les coûts.
En augmentant les ressources uniquement en cas de besoin et en les réduisant lorsque la demande diminue, Amazon peut gérer efficacement les coûts sans sacrifier les performances.
Cette approche garantit que l’infrastructure n’est pas sous-utilisée pendant les heures creuses et surchargée pendant les périodes de forte demande, en maintenant un équilibre optimal qui favorise l’innovation continue axée sur l’IA et la satisfaction des clients.
3. Stockage et gestion de grands volumes
Les systèmes d’IA nécessitent la capacité de stocker et de gérer d’importants volumes de données.
Cela nécessite des solutions de stockage rapides et évolutives, telles que le stockage d’objets pour les données non structurées et les bases de données à haute performance pour les données structurées.
Un accès rapide et fiable à ces données est impératif pour une formation efficace des modèles d’intelligence artificielle.
Pour y parvenir, il peut être nécessaire d’utiliser une mise en cache avancée des données, de déployer un réseau à large bande passante et de mettre en œuvre des systèmes efficaces de récupération des données.
Ceph, en tant que solution de stockage, est un exemple de flexibilité et d’efficacité dans le traitement de grands volumes de données.
Il garantit la compatibilité avec les applications existantes et facilite l’intégration avec les plateformes en nuage, ce qui en fait une solution rentable.
En outre, Ceph réduit considérablement les dépenses liées au stockage des données d’entreprise et aide les organisations à gérer la croissance exponentielle des données. En fonctionnant sur du matériel serveur de base, Ceph peut réduire les dépenses d’investissement (CapEx) et les dépenses opérationnelles (OpEx) grâce à ses capacités d’autogestion et d’autoréparation.
L’utilisation de NVMe over Fabrics (NVMe-oF) est un autre moyen de fournir efficacement un stockage de masse des données et une capacité élevée. Il ne s’agit pas d’un produit d’un seul fabricant, mais plutôt d’une norme que diverses entreprises peuvent utiliser pour créer leurs produits et solutions.
NVMe over Fabrics (NVMe-oF) peut considérablement aider à construire des systèmes de stockage de données puissants et rentables, en particulier lorsque des performances et une évolutivité élevées sont requises. NVMe-oF exploite les avantages des disques SSD NVMe, tels que la faible latence et les vitesses de transfert de données élevées sur les connexions réseau. Cela permet aux systèmes distants d’accéder aux données presque aussi rapidement que si les périphériques de stockage étaient connectés localement via PCIe, ce qui est idéal pour les applications à forte demande telles que les bases de données, les charges de travail informatiques importantes et le traitement des big data en temps réel.
Un autre avantage est la facilité d’évolution des systèmes de stockage par l’ajout de périphériques NVMe au réseau sans perte de performance, ce qui permet aux entreprises de répondre à des besoins croissants en matière de stockage de données sans devoir procéder à une refonte complète de l’infrastructure.
Bien que les périphériques NVMe puissent être plus chers que les disques SSD ou HDD SATA traditionnels, l’utilisation de NVMe-oF permet de créer des systèmes de stockage plus efficaces et plus rapides.
Les économies sont réalisées grâce à de meilleures performances par dispositif, ce qui peut réduire le nombre total de dispositifs nécessaires et diminuer les coûts de maintenance et d’énergie.
4. Fournisseurs de logiciels et de plateformes en nuage
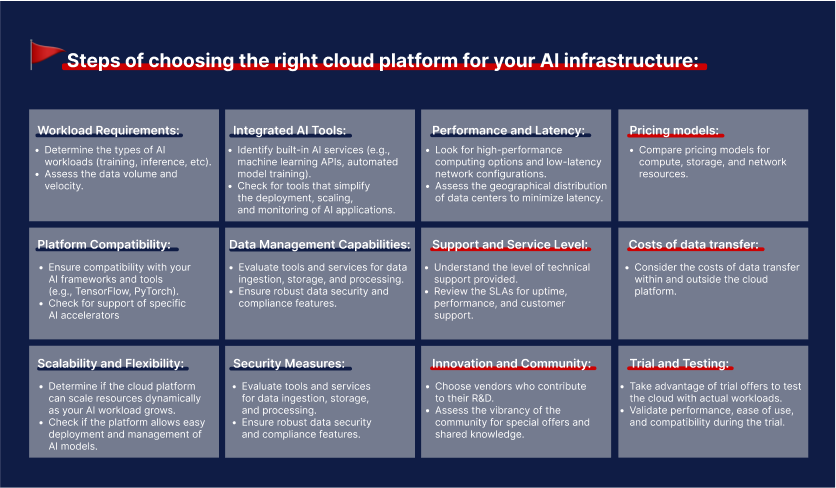
Le choix de la bonne plateforme cloud ou du bon fournisseur est une décision cruciale pour l’infrastructure d’IA. Bien que la plupart des plateformes cloud soient capables de prendre en charge des charges de travail d’IA, la principale considération doit être la compatibilité avec le processeur choisi pour votre système. Toutefois, pour qu’une infrastructure soit réellement efficace, cette seule considération ne suffit pas.
L’expertise de l’équipe chargée de l’infrastructure de l’IA est essentielle pour obtenir des performances optimales.
Malgré la prévalence de la virtualisation en nuage, elle n’est pas toujours la meilleure pour les systèmes d’IA.
Un modèle hybride de cloud, de virtualisation et de bare metal, comme illustré dans un cas, peut répondre efficacement aux exigences de l’apprentissage profond, en combinant la distribution de la puissance de calcul avec un accès bare metal de haute performance.
Il est donc essentiel que les fournisseurs comprennent précisément les objectifs du système afin d’adapter la solution de technologie cloud la plus efficace.
L’une des organisations financières, JPMorgan Chase, a dû relever le défi de traiter de grandes quantités de données pour l’analyse financière en temps réel et la gestion des risques.
Reconnaissant les limites de la virtualisation traditionnelle du nuage pour ses charges de travail spécifiques d’IA, JPMorgan Chase a adopté une infrastructure de nuage hybride qui combine des solutions de nuage, de virtualisation et de métal nu.
Ce modèle hybride permet à JPMorgan Chase de tirer parti de la flexibilité du cloud et de la virtualisation pour l’évolutivité et la rentabilité, tout en utilisant la puissance des serveurs » bare metal » pour gérer les tâches d’IA à forte intensité de calcul.
Les serveurs » bare metal » offrent un accès direct aux ressources matérielles, en évitant les frais généraux liés à la virtualisation, ce qui est crucial pour les besoins en performances des algorithmes d’apprentissage profond utilisés dans la modélisation financière et l’évaluation des risques.
L’infrastructure doit être suffisamment souple pour s’adapter à l’évolution des demandes en matière d’IA, ce qui permet d’intégrer de nouvelles technologies et d’ajuster ou d’étendre les ressources avec un minimum de perturbations.
De nombreux fournisseurs de cloud proposent des services d’IA et d’apprentissage automatique qui peuvent être intégrés à l’infrastructure d’IA, donnant accès à des outils puissants pour le développement, la formation et le déploiement de modèles.
Des technologies telles qu’OpenStack pour la virtualisation et Kubernetes pour la conteneurisation jouent un rôle essentiel dans la gestion des applications d’IA.
Elles simplifient le déploiement, la mise à l’échelle et l’exploitation des charges de travail d’IA dans des environnements variés, améliorant ainsi l’agilité et la réactivité de l’infrastructure face à l’évolution des besoins.
5. Efficacité énergétique et consommation
L’intégration de l’IA dans l’infrastructure informatique renforce les capacités de traitement des données et d’exécution des algorithmes, mais soulève des problèmes de consommation d’énergie, en particulier pour les modèles d’apprentissage profond qui nécessitent une puissance de calcul importante. L’aspect énergétique est le plus délicat car la stratégie classique d’amélioration de l’efficacité énergétique consiste à redistribuer les charges et à mettre hors tension les capacités inutilisées.
Toutefois, dans le contexte de l’IA, l’arrêt des machines peut s’avérer particulièrement difficile et n’améliorer l’efficacité énergétique que de manière marginale.
Il est donc conseillé de se concentrer sur l’équilibre des performances et sur l’identification et la gestion des composants de l’infrastructure qui consomment le plus d’énergie.
Dans les infrastructures d’IA, il s’agit généralement de GPU, de FPGA et d’autres composants matériels qui nécessitent un refroidissement continu ou une dissipation de la chaleur.
S’il s’avère difficile d’optimiser directement l’utilisation de l’énergie, il est possible de réaliser des économies significatives en améliorant l’efficacité des systèmes de refroidissement.
Par exemple, les centres de données en Islande, comme Borealis ou atNorth, illustrent une approche efficace de la gestion de l’énergie.
Tirant parti du climat frais de l’Islande et de l’abondance des sources d’énergie renouvelables, ces centres de données utilisent le refroidissement naturel et l’énergie géothermique, ce qui réduit considérablement le besoin de refroidissement artificiel et, par conséquent, la consommation énergétique globale des infrastructures d’intelligence artificielle.
Cependant, opérer en Islande présente également des défis, notamment en ce qui concerne la latence du réseau et la connectivité en raison de l’éloignement.
Il est donc judicieux de choisir avec soin les types de charges de travail et le calendrier des projets exécutés dans ces centres de données.
Les charges de travail qui sont moins sensibles à la latence ou celles qui peuvent être programmées pendant les heures creuses peuvent optimiser à la fois la consommation d’énergie et les performances du réseau, en tirant le meilleur parti de l’environnement unique de l’Islande tout en atténuant les inconvénients potentiels.
Cette approche stratégique souligne l’importance d’une planification réfléchie de l’infrastructure pour maximiser à la fois les performances et l’efficacité énergétique des opérations d’IA.
Les GPU et TPU économes en énergie et l’optimisation des algorithmes d’IA par l’élagage et la quantification des modèles, qui sont essentiels pour réduire la consommation d’énergie tout en maintenant les performances, constituent un autre moyen d’explorer l’amélioration de l’efficacité énergétique. Les avancées technologiques dans le domaine des semi-conducteurs et des accélérateurs d’IA contribuent également à réduire la consommation d’énergie.

En outre, l’adoption de technologies écologiques pour les centres de données, l’exploitation de la virtualisation et de l’informatique en nuage, ainsi que l’utilisation de la mise à l’échelle dynamique et de la gestion des ressources pilotée par l’IA améliorent l’efficacité énergétique des opérations d’IA en adaptant l’utilisation des ressources à la demande. Cela garantit une utilisation efficace de l’énergie dans les infrastructures informatiques sans sacrifier les performances.
En conclusion, pour les organisations visant à exploiter l’innovation et à acquérir un avantage concurrentiel, il est essentiel de transformer l’infrastructure informatique pour qu’elle soit prête pour l’IA. Donner la priorité à l’amélioration des données, investir dans du matériel spécialisé, intégrer des solutions cloud robustes, sécuriser les réseaux et former une équipe compétente sont des étapes fondamentales qui jettent les bases d’un déploiement efficace de l’IA et des progrès technologiques à venir. Ces efforts garantissent la réussite de la mise en œuvre de l’IA et la flexibilité nécessaire pour s’adapter aux nouvelles avancées et opportunités de l’IA.
Si vous avez besoin de l’aide d’un expert pour transformer votre infrastructure en nuage, cliquez ici pour planifier une consultation gratuite avec notre équipe. Nous sommes toujours là pour aider les entreprises à tirer le meilleur parti de leur infrastructure cloud.