


Descubre cómo transformar tu infraestructura en la nube para cargas de trabajo de IA: desde el ahorro de costes hasta el de recursos.
Esta es una copia de un artículo publicado en Spiceworks. Haz clic aquí para leer la versión original.
El doctor Kenneth Tan, director ejecutivo y responsable de tecnología multilingüe de Sardina Systems, profundiza en la creciente necesidad de las empresas de integrar hábilmente la IA en sus operaciones, ofreciendo ideas estratégicas sobre la creación de una sólida infraestructura de IA para liberar todo su potencial de innovación y eficacia empresarial.
En los últimos años, la rápida expansión de la inteligencia artificial (IA) ha revolucionado el mundo empresarial, creando una demanda de capacidades de IA que a menudo superan las estrategias organizativas existentes. Esto ha llevado a las empresas a buscar formas eficaces de integrar la IA en sus operaciones.
¿Cómo y dónde se debe empezar con la infraestructura de IA, centrándose en una estrategia a largo plazo para maximizar el potencial de la IA?
Las empresas automatizan cada vez más departamentos con IA e integran nuevas funciones de IA en sus aplicaciones. A pesar del crecimiento en la adopción de la IA, como pone de relieve la investigación de McKinsey que muestra un aumento significativo desde 2017, la aplicación de las herramientas de IA todavía se basa en gran medida en el uso personal y la optimización de la rutina diaria.
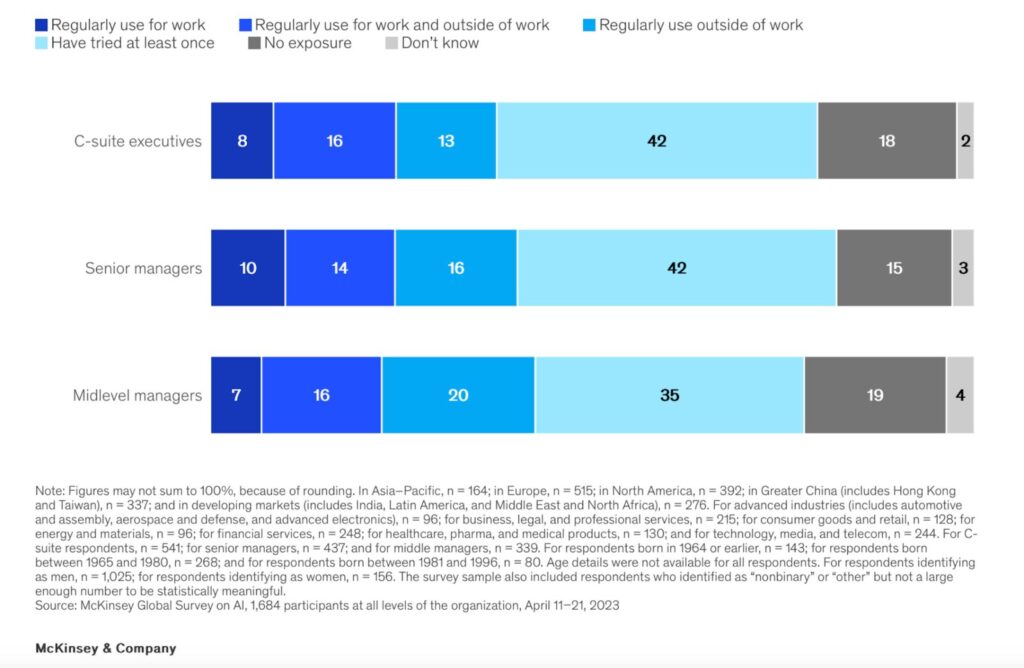
Al mismo tiempo, la IA se está desarrollando rápidamente a nivel empresarial. Nuestros clientes, incluidos los que ofrecen la IA como servicio y los que la integran en sus productos, ilustran la demanda del mercado de herramientas de IA fácilmente integrables y el desarrollo de servicios innovadores, como proporcionar a los investigadores acceso a recursos computacionales.
Este artículo se dirige tanto a los proveedores de servicios como a los incorporadores de productos, y subraya la importancia de una infraestructura informática escalable y bien planificada para evitar gastos innecesarios y la obsolescencia debida a la rápida evolución de las tecnologías. Iniciar el viaje hacia la integración de la infraestructura de la IA requiere comprender las capacidades actuales y planificar estratégicamente las necesidades futuras. Esbozamos cinco pasos esenciales para recorrer este proceso con eficacia.
1. Evaluación de la infraestructura actual
Es imprescindible un enfoque estratégico de la nube y de la infraestructura informática en general.
Los cambios, especialmente en la infraestructura informática básica, requieren una evaluación exhaustiva del modelo empresarial y de las cargas de trabajo previstas, quizá con años de antelación, lo que pone de relieve la importancia crítica de una planificación meticulosa en la era de la IA.
El paso inicial en esta transformación implica realizar una evaluación en profundidad de la infraestructura informática actual, señalando los puntos fuertes, los puntos débiles y las lagunas en relación con los requisitos de la IA.
Esta evaluación debe abarcar el hardware (por ejemplo, servidores, almacenamiento, redes), el software (por ejemplo, bases de datos, plataformas de aplicaciones) y las prácticas de gestión de datos existentes.
Comprender el estado actual de la infraestructura informática es esencial para planificar las actualizaciones o cambios necesarios para la adopción de la IA.
Varios conceptos y marcos ayudan tradicionalmente a las organizaciones a evaluar su infraestructura informática.
La utilización de estas metodologías puede ofrecer enfoques estructurados para evaluar la eficacia, eficiencia, seguridad y alineación de los sistemas informáticos con los objetivos empresariales:
- Entre las metodologías clásicas, la ITIL (Biblioteca de Infraestructuras de Tecnologías de la Información) es especialmente relevante, ya que la integración de la IA debe estar estrechamente alineada con la estrategia empresarial. Desarrollada por el Gobierno del Reino Unido y actualizada periódicamente, ITIL ofrece un marco detallado para la gestión de los servicios de TI, con el fin de alinear los servicios de TI con las necesidades empresariales, abarcando desde el diseño del servicio hasta su mejora. Fomenta un enfoque flexible de la gestión de TI, y la ITIL 4 aporta avances significativos. Integrar la gestión con la tecnología es esencial; un enfoque meramente técnico puede pasar por alto repercusiones más amplias, especialmente en la integración de la IA.
- Otro relevante es COBIT, de la Asociación de Auditoría y Control de Sistemas de Información, que proporciona un marco integral para la gestión y el gobierno de las TI empresariales, garantizando la alineación con los objetivos empresariales, la gestión de riesgos y la optimización del rendimiento. Utilizar COBIT garantiza que las actualizaciones de TI mejoren la eficacia y se ajusten a las mejores prácticas de automatización y gestión.
2. Potencia de cálculo y procesadores de alto rendimiento
La IA, y el aprendizaje profundo en particular, exigen procesadores con importantes capacidades computacionales, como las Unidades de Procesamiento Gráfico (GPU), las Unidades de Procesamiento Tensorial (TPU) o las Matrices de Compuertas Programables en Campo (FPGA).
El mercado del hardware está en constante evolución, con nuevos procesadores y aceleradores diseñados para la IA que surgen en todo el mundo.
Una de estas innovaciones recientes es el procesador Gaudi3.
Aunque puede ser prematuro adoptar nuevos productos precipitadamente, sin duda es crucial seguir de cerca el mercado, mantenerse informado sobre las soluciones novedosas y explorar a fondo este sector.
Entre las cuestiones clave que hay que considerar figuran en qué se diferencian cualitativamente estas nuevas ofertas, qué software es capaz de soportar esa infraestructura, y si las nuevas soluciones pueden abordar los retos actuales a los que se enfrenta tu sistema.
Las GPU son la opción más popular hoy en día debido a su amplia disponibilidad comercial y a su alto rendimiento.
Al seleccionar una GPU para la infraestructura de IA, es importante tener en cuenta los requisitos específicos de tu carga de trabajo.
Esto incluye determinar si la atención se centra en el entrenamiento o en la inferencia, evaluar el tamaño y la complejidad de tus modelos, considerar las limitaciones presupuestarias y evaluar el ecosistema de software.
Las GPU de NVIDIA, especialmente las A100, H100 o H200, gozan de gran popularidad en el sector por su rendimiento, amplio soporte de software y funciones especializadas de aceleración de IA.
Sin embargo, AMD e Intel se están convirtiendo en alternativas cada vez más viables, sobre todo en escenarios en los que sus características únicas o su rentabilidad presentan claras ventajas.
Otra consideración crítica es la capacidad de escalar los recursos según las demandas de carga de trabajo.
Esta escalabilidad es esencial para gestionar los costes y mantener la eficacia a lo largo de las distintas fases de desarrollo y despliegue de los modelos de IA.
Para ilustrar el papel fundamental de la escalabilidad en las operaciones de IA, considera la demanda estacional regular a la que se enfrentan las principales plataformas de comercio electrónico.
Amazon utiliza la IA para optimizar varios aspectos de sus operaciones, como la gestión de inventarios, las recomendaciones personalizadas y la logística.
Durante los periodos punta de compras, como el Viernes Negro o el Ciberlunes, la demanda de los sistemas de Amazon aumenta drásticamente.
Para gestionar esto, Amazon aprovecha las plataformas de computación en nube que permiten el escalado dinámico de los recursos.
Esta escalabilidad es crucial para gestionar el aumento del tráfico y los costes.
Aumentando los recursos sólo cuando es necesario y reduciéndolos cuando disminuye la demanda, Amazon puede gestionar eficazmente los costes sin sacrificar el rendimiento.
Este enfoque garantiza que la infraestructura no esté infrautilizada durante las horas valle y sobrecargada durante los periodos de alta demanda, manteniendo un equilibrio óptimo que respalde la innovación continua impulsada por la IA y la satisfacción del cliente.
3. Almacenamiento y gestión de grandes volúmenes
Los sistemas de IA requieren la capacidad de almacenar y gestionar volúmenes considerables de datos.
Esto requiere soluciones de almacenamiento rápidas y escalables, como el almacenamiento de objetos para datos no estructurados y bases de datos de alto rendimiento para datos estructurados.
El acceso rápido y fiable a estos datos es imprescindible para el entrenamiento eficaz de los modelos de IA.
Conseguirlo puede implicar la utilización de cachés de datos avanzados, el despliegue de redes de gran ancho de banda y la implantación de sistemas eficientes de recuperación de datos.
Ceph, como solución de almacenamiento, es un ejemplo de flexibilidad y eficiencia en el manejo de grandes volúmenes de datos.
Garantiza la compatibilidad con las aplicaciones existentes y facilita la integración con plataformas en la nube, lo que la convierte en una solución rentable.
Además, Ceph reduce significativamente los gastos asociados al almacenamiento de datos empresariales y ayuda a las organizaciones a gestionar el crecimiento exponencial de los datos. Al ejecutarse en hardware de servidor básico, Ceph puede reducir los gastos de capital (CapEx) y los gastos operativos (OpEx) gracias a sus capacidades de autogestión y autorreparación.
Una forma alternativa de proporcionar almacenamiento masivo de datos y alta capacidad de forma eficiente es utilizar NVMe sobre tejidos (NVMe-oF). No es un producto de un único fabricante, sino un estándar que varias empresas pueden utilizar para crear sus productos y soluciones.
NVMe sobre tejidos (NVMe-oF) puede ayudar significativamente a crear sistemas de almacenamiento de datos potentes y rentables, especialmente cuando se requieren alto rendimiento y escalabilidad. NVMe-oF aprovecha las ventajas de las SSD NVMe, como la baja latencia y las altas velocidades de transferencia de datos a través de conexiones de red. Esto permite a los sistemas remotos acceder a los datos casi tan rápido como si los dispositivos de almacenamiento estuvieran conectados localmente mediante PCIe, lo que resulta ideal para aplicaciones de alta demanda como bases de datos, grandes cargas de trabajo computacionales y procesamiento de big data en tiempo real.
Otra ventaja es la fácil escalabilidad de los sistemas de almacenamiento añadiendo más dispositivos NVMe a la red sin pérdida de rendimiento, lo que permite a las organizaciones satisfacer las crecientes necesidades de almacenamiento de datos sin una revisión completa de la infraestructura.
Aunque los dispositivos NVMe pueden ser más caros que los SSD o HDD SATA tradicionales, el uso de NVMe-oF puede crear sistemas de almacenamiento más eficientes y rápidos.
El ahorro se consigue gracias a un mayor rendimiento por dispositivo, lo que puede reducir el número total de dispositivos necesarios y disminuir los costes de mantenimiento y energía.
4. Proveedores de software y plataformas en la nube
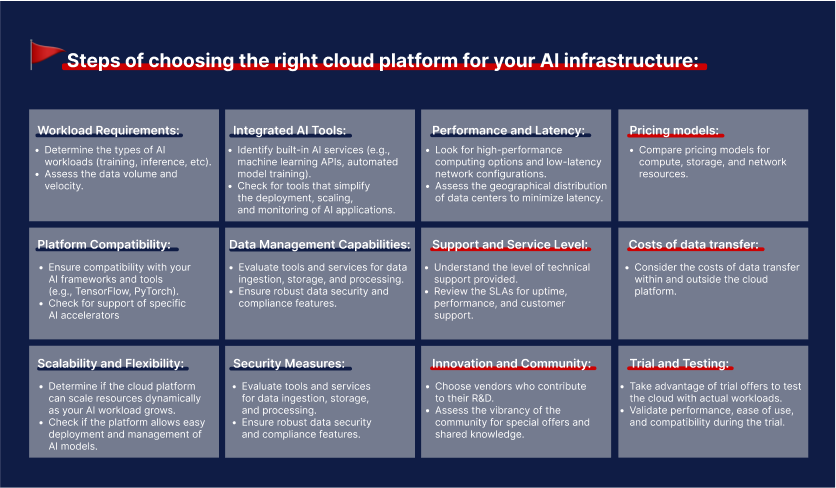
Elegir la plataforma en la nube o el proveedor adecuados es una decisión crítica para la infraestructura de IA. Aunque la mayoría de las plataformas en la nube son capaces de soportar cargas de trabajo de IA, la principal consideración debe ser la compatibilidad con el procesador seleccionado para tu sistema. Sin embargo, para que una infraestructura sea realmente eficaz, esto por sí solo no es suficiente.
La experiencia del equipo de infraestructura de IA es vital para conseguir un rendimiento óptimo.
A pesar de la prevalencia de la virtualización en la nube, puede que no siempre sea lo mejor para los sistemas de IA.
Un modelo híbrido de nube, virtualización y metal desnudo, como se muestra en un caso, puede satisfacer eficazmente las demandas del aprendizaje profundo, combinando la distribución de la potencia informática con el acceso de alto rendimiento al metal desnudo.
Por tanto, es crucial que los proveedores comprendan con precisión los objetivos del sistema para adaptar la solución tecnológica en la nube más eficaz.
Una de las organizaciones financieras, JPMorgan Chase, se enfrentaba al reto de procesar grandes cantidades de datos para el análisis financiero y la gestión de riesgos en tiempo real.
Reconociendo las limitaciones de la virtualización tradicional de la nube para sus cargas de trabajo específicas de IA, JPMorgan Chase adoptó una infraestructura de nube híbrida que combina soluciones de nube, virtualización y bare metal.
Este modelo híbrido permite a JPMorgan Chase aprovechar la flexibilidad de la nube y la virtualización para la escalabilidad y la rentabilidad, al tiempo que utiliza la potencia de los servidores de metal desnudo para gestionar las tareas de IA de cálculo intensivo.
Los servidores de metal desnudo proporcionan acceso directo a los recursos de hardware, evitando la sobrecarga que conlleva la virtualización, que es crucial para los requisitos de rendimiento intensivo de los algoritmos de aprendizaje profundo utilizados en el modelado financiero y la evaluación de riesgos.
La infraestructura debe ser lo suficientemente flexible como para adaptarse a la evolución de la demanda de IA, permitiendo la incorporación de nuevas tecnologías y el ajuste o ampliación de los recursos con una interrupción mínima.
Muchos proveedores en la nube ofrecen servicios de IA y aprendizaje automático que pueden integrarse en la infraestructura de IA, proporcionando acceso a potentes herramientas para el desarrollo, entrenamiento y despliegue de modelos.
Tecnologías como OpenStack para la virtualización y Kubernetes para la contenerización desempeñan un papel vital en la gestión de las aplicaciones de IA.
Simplifican el despliegue, el escalado y el funcionamiento de las cargas de trabajo de IA en distintos entornos, mejorando la agilidad de la infraestructura y su capacidad de respuesta a las necesidades cambiantes.
5. Eficiencia energética y consumo
La incorporación de la IA a la infraestructura informática potencia las capacidades de procesamiento de datos y ejecución de algoritmos, pero plantea problemas de consumo energético, especialmente para los modelos de aprendizaje profundo que necesitan una potencia de cálculo considerable. La parte energética es el aspecto más difícil, porque la estrategia convencional para mejorar la eficiencia energética consiste en redistribuir las cargas y apagar las capacidades no utilizadas.
Sin embargo, en el contexto de la IA, apagar las máquinas puede ser especialmente difícil y mejorar sólo marginalmente la eficiencia energética.
Por tanto, es aconsejable centrarse en equilibrar el rendimiento e identificar y gestionar los componentes de la infraestructura que consumen más energía.
En la infraestructura de IA, suelen ser GPUs, FPGAs y otros componentes de hardware que requieren refrigeración continua o disipación de calor.
Si resulta difícil optimizar directamente el uso de la energía, aún se puede conseguir un ahorro significativo mejorando la eficiencia de los sistemas de refrigeración.
Por ejemplo, los centros de datos de Islandia, como Borealis o atNorth, ilustran un enfoque eficaz de la gestión energética.
Aprovechando el clima fresco de Islandia y las abundantes fuentes de energía renovable, estos centros de datos utilizan la refrigeración natural y la energía geotérmica, reduciendo significativamente la necesidad de refrigeración artificial y, por tanto, disminuyendo el consumo total de energía de las infraestructuras de IA.
Sin embargo, operar en Islandia también presenta retos, sobre todo con la latencia de la red y la conectividad, debido a su ubicación remota.
Por ello, es aconsejable elegir cuidadosamente los tipos de cargas de trabajo y el calendario de los proyectos ejecutados en estos centros de datos.
Las cargas de trabajo que son menos sensibles a la latencia o las que pueden programarse en horas valle pueden optimizar tanto el uso de la energía como el rendimiento de la red, aprovechando al máximo el entorno único de Islandia y mitigando al mismo tiempo los posibles inconvenientes.
Este enfoque estratégico subraya la importancia de una planificación meditada de la infraestructura para maximizar tanto el rendimiento como la eficiencia energética en las operaciones de IA.
Otra forma de explorar la mejora de la eficiencia energética son las GPU y TPU energéticamente eficientes, y la optimización de los algoritmos de IA mediante la poda de modelos y la cuantización, que son clave para reducir el uso de energía manteniendo el rendimiento. Los avances tecnológicos en semiconductores y aceleradores de IA también ayudan a reducir el consumo de energía.

Además, la adopción de tecnologías ecológicas para los centros de datos, el aprovechamiento de la virtualización y la computación en nube, y el empleo del escalado dinámico y la gestión de recursos impulsada por la IA mejoran la eficiencia energética en las operaciones de IA al adaptar el uso de los recursos a la demanda. Esto garantiza un uso eficiente de la energía en todas las infraestructuras de TI sin sacrificar el rendimiento.
En conclusión, para las organizaciones que pretenden aprovechar la innovación y obtener una ventaja competitiva, es esencial transformar la infraestructura informática para que esté preparada para la IA. Dar prioridad a la mejora de los datos, invertir en hardware especializado, integrar soluciones sólidas en la nube, proteger las redes y cultivar un equipo cualificado son pasos fundamentales que sientan las bases para un despliegue eficaz de la IA y futuros avances tecnológicos. Estos esfuerzos garantizan el éxito de la implantación de la IA y la flexibilidad para adaptarse a los nuevos avances y oportunidades de la IA.
Si necesitas ayuda experta para transformar tu infraestructura en la nube, haz clic aquí para programar una consulta gratuita con nuestro equipo. Siempre estamos aquí para ayudar a las empresas a sacar el máximo partido de su infraestructura en la nube.