


Die rapide Entwicklung des Servermarktes stellt Unternehmen vor eine entscheidende Wahl: Investition in wenige Hochleistungsmaschinen oder Aufbau einer verteilten Infrastruktur mit mehreren kleineren Servern. Dieser Artikel von Experten von Sardina Systems, erstellt in Zusammenarbeit mit unseren Partnern bei Vespertec, vertieft dieses Thema und bietet Einblicke, wie Unternehmen fundierte Entscheidungen zur Deckung ihres Infrastrukturbedarfs treffen können.
Auf den ersten Blick mag die Investition in einen einzelnen Hochleistungsserver als die beste Lösung erscheinen. Reale Implementierungen zeigen jedoch ein anderes Bild. In vielen Fällen entspricht ein verteilter Cluster kleinerer Server, insbesondere in Kombination mit fortschrittlichen Cloud-Management-Lösungen wie FishOS, nicht nur der Leistung eines einzelnen leistungsstarken Systems, sondern übertrifft diese oft in Bezug auf Kosteneffizienz, Zuverlässigkeit, Skalierbarkeit und Verwaltungsfreundlichkeit.
Zwei grundlegende Ansätze zur Infrastruktur
In Bezug auf IT-Infrastruktur stehen Unternehmen im Wesentlichen vor zwei grundlegenden Ansätzen:
- Hochleistungsserver. Monolithische Systeme mit leistungsstarken Prozessoren, großer Speicherkapazität und Hochgeschwindigkeitsnetzwerken. Diese werden häufig für ressourcenintensive Anwendungen wie große Datenbanken, KI-Training und Finanzmodellierung eingesetzt.
- Verteilte Cluster. Ein Netzwerk kleinerer, miteinander verbundener Server, die Arbeitslasten teilen. Dieses Modell bietet Skalierbarkeit, Fehlertoleranz und Kosteneffizienz, was es ideal für Cloud-native Umgebungen, containerisierte Anwendungen und skalierbare Webdienste macht.
Mit der Weiterentwicklung der Servertechnologie sind diese Kategorien jedoch nicht mehr so starr wie früher. Der Markt bietet nun spezialisierte Lösungen, die Elemente beider Ansätze kombinieren und verschiedene Geschäftsanforderungen erfüllen. Die Wahl der richtigen Infrastruktur erfordert eine eingehende Analyse der Workload-Anforderungen, operativen Risiken und langfristigen Kosten.
„Enterprise-Server, die auf AMD EPYC oder Intel Xeon CPUs basieren, liefern hohe Leistung für datenintensive Operationen. Gleichzeitig gewinnen energieeffiziente ARM-basierte Server von Anbietern wie NVIDIA und Ampere an Bedeutung bei Organisationen, die Nachhaltigkeit priorisieren,“ –
Philip Kaye, Mitbegründer und Direktor bei Vespertec.
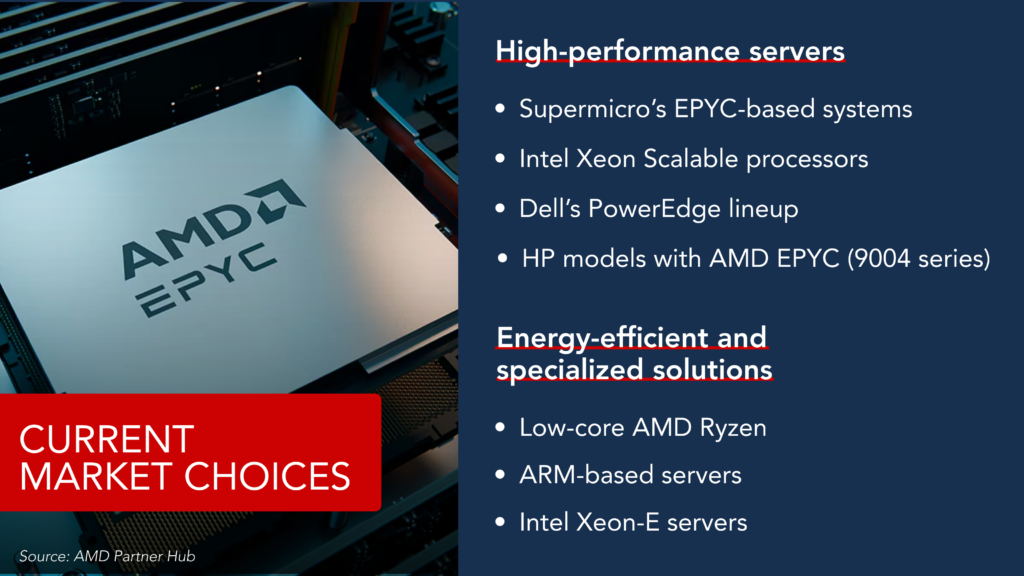
Während die grundlegende Unterscheidung zwischen Hochleistungs- und verteilter Infrastruktur weiterhin relevant bleibt, müssen Unternehmen die Nuancen jedes Ansatzes bewerten, um eine fundierte Entscheidung zu treffen, die mit ihrer operativen und finanziellen Strategie übereinstimmt. „Größer und teurer“ ist nicht immer gleichbedeutend mit „besser“. Lassen Sie uns untersuchen, warum.
Zuverlässigkeit und Fehlertoleranz: Das Risiko eines einzigen Ausfallpunkts
Einer der kritischsten Nachteile der Abhängigkeit von einem einzigen Hochleistungsserver ist das Ausfallrisiko. Wenn das System ausfällt, wird alles damit Verbundene, einschließlich Speicher, Workloads und Anwendungen, unverfügbar.
In einer traditionellen Einzelserver-Konfiguration ist die Fehlertoleranz in der Regel auf grundlegende Schutzmaßnahmen wie Festplatten-Redundanz beschränkt. Bei einer verteilten Infrastruktur hingegen kommen mehrere Ebenen der Fehlertoleranz zum Einsatz, die robusten Schutz bieten und Ausfallzeiten minimieren. Mit kleineren Servern, die über ein Netzwerk verteilt sind, werden Arbeitslasten geteilt, und jeder Server fungiert als Backup für andere im Falle eines Ausfalls.
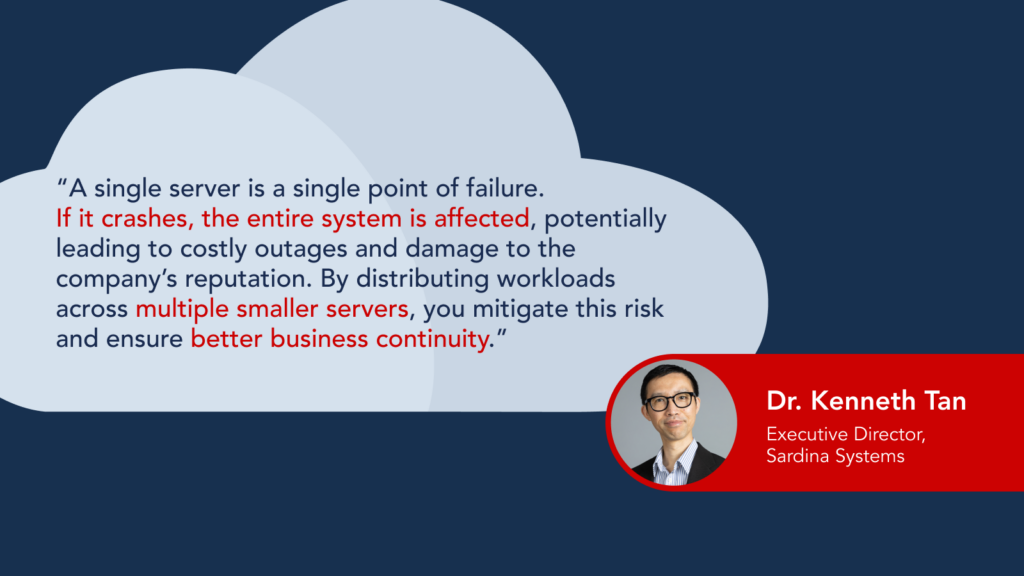
Dieses Prinzip ist entscheidend für Cloud-native Anwendungen, die auf Microservices basieren und von Redundanz profitieren. Selbst für traditionelle Unternehmensworkloads kann ein verteilter Ansatz besseren Schutz vor Ausfallzeiten bieten.
FishOS, die OpenStack-basierte Cloud-Management-Lösung von Sardina Systems, erfordert mindestens drei Knoten (wobei Compute- und Controller-Funktionen zusammengelegt werden können) innerhalb der Standard-Lizenz, um Redundanz und Verfügbarkeit zu gewährleisten. Dies stellt sicher, dass bei Ausfall eines Servers andere nahtlos übernehmen können, wodurch Ausfallzeiten verhindert und kontinuierliche Geschäftsabläufe sichergestellt werden.
Skalierbarkeit: Müheloses Wachstum
Unternehmen, die Wachstum oder schwankende Arbeitslasten erfahren, benötigen eine Infrastruktur, die sich anpassen kann. Ein einzelner leistungsstarker Server hat feste Kapazitäten, was die Skalierbarkeit komplex und kostspielig macht.
Eine verteilte Konfiguration ermöglicht es Unternehmen jedoch, inkrementell zu skalieren, indem sie nach Bedarf Server hinzufügen. Dieser modulare Ansatz erlaubt es Firmen, Ressourcen dynamisch zuzuweisen und somit eine optimale Nutzung zu gewährleisten, ohne im Vorfeld in eine einzelne, leistungsstarke Maschine überinvestieren zu müssen.
Ausfallzeiten und Wartung: Die Aufrechterhaltung des Geschäftsbetriebs
Ein weiterer Faktor, den Unternehmen berücksichtigen müssen, sind betriebliche Ausfallzeiten während Aktualisierungen und Wartungsarbeiten. Hochleistungsserver erfordern oft vollständige Systemneustarts für Softwarepatches, Firmware-Upgrades oder Hardwarewartung. Dies führt zu Geschäftsunterbrechungen, die sich auf Umsatz und Produktivität auswirken können.
Mit mehreren kleineren Servern können Aktualisierungen rollierend durchgeführt werden. Einige Server bleiben betriebsbereit, während andere gewartet werden, wodurch die Auswirkungen auf die Geschäftskontinuität reduziert werden.
Darüber hinaus kann der Austausch oder die Aufrüstung von Systemen störend sein, insbesondere für Unternehmen mit 24/7-Verfügbarkeitsanforderungen. Wenn diese Upgrades nicht ordnungsgemäß geplant werden, können sie zu erheblichen Ausfallzeiten führen.
Speichereffizienz und -leistung
Speicher ist oft ein übersehener Faktor beim Vergleich von Einzel- vs. Mehrserver-Architekturen. Ein einzelner leistungsstarker Server mag eine hohe Speicherkapazität bieten, optimiert jedoch nicht unbedingt die Leistung. Die Speichereffizienz verbessert sich, wenn Daten über mehrere Knoten verteilt sind, was die Redundanz und Abrufgeschwindigkeit erhöht.
„Ceph-Speicher, der häufig für verteilte Setups verwendet wird, funktioniert aufgrund der verteilten Lasthandhabung besser mit einer größeren Anzahl von Knoten. Zum Beispiel bietet eine 3-Knoten-Konfiguration mit 100 TB pro Knoten die gleiche Kapazität wie 6 Knoten mit je 50 TB, aber letztere bietet eine bessere Fehlertoleranz und Effizienz,“ –
Kenneth Tan, Geschäftsführender Direktor bei Sardina Systems.
Während einige Replikationsmethoden Effizienz für Redundanz opfern, finden Techniken wie Erasure Coding eine Balance zwischen Fehlertoleranz und Leistung.
Kostenüberlegungen: Die langfristige Investition
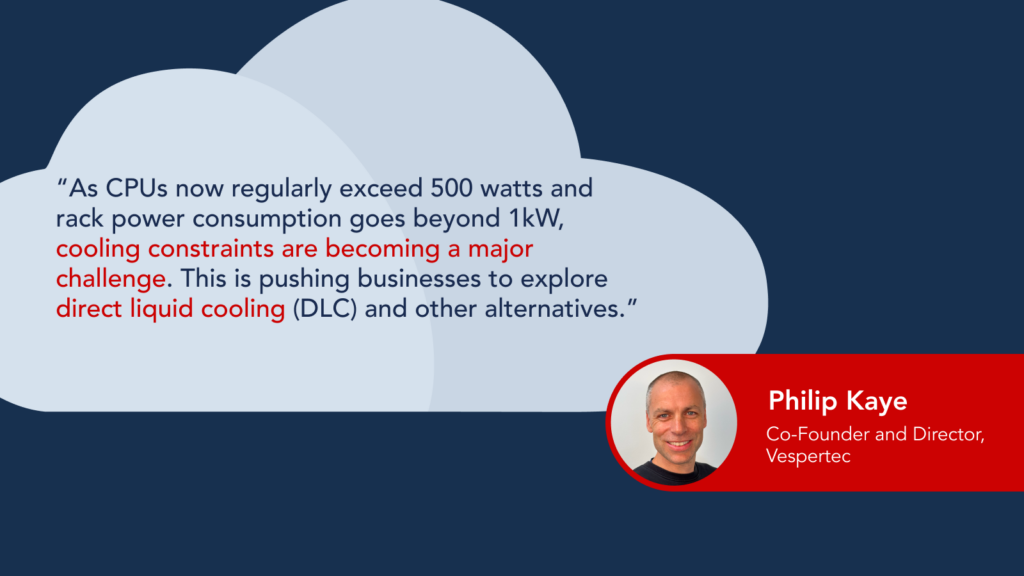
Während ein Hochleistungsserver zunächst wie eine kosteneffektive Lösung erscheinen mag, müssen Unternehmen langfristige Ausgaben berücksichtigen. Stromverbrauch, Kühlanforderungen und komplexe Wartung können die Betriebskosten erhöhen.
Cluster kleinerer Server bieten hingegen einen graduelleren Investitionspfad. Unternehmen können ihre Infrastruktur nach Bedarf skalieren, große Vorabkosten vermeiden und Ausgaben über die Zeit verteilen. Zusätzlich ermöglichen modulare Upgrades den Unternehmen, veraltete Server auszutauschen, ohne das gesamte System zu stören.
Basierend auf den Erfahrungen von Sardina Systems wird die Kostenoptimierung nicht nur durch Faktoren wie Energieeffizienz und Kühlung beeinflusst, sondern auch durch die Anzahl der Server selbst. Überraschenderweise kann eine größere Anzahl kleinerer Knoten die Leistungsanforderungen zu geringeren Gesamtkosten erfüllen.
In einer kürzlich durchgeführten Kostenanalyse für einen Kunden führte ein 14-Knoten-System zu etwa 24% Einsparungen im Vergleich zu einem 7-Knoten-System, während der gleiche RAM (6.680 GB) und vCPUs (2000) beibehalten wurden. Dieser Kostenvorteil wird durch Schlüsselfaktoren wie effiziente Ressourcenzuweisung, verbesserte Redundanz und höhere Speichereffizienz angetrieben.
Die kluge Entscheidung treffen
Für Organisationen, die ihre Serverinfrastrukturoptionen evaluieren, ist die wichtigste Erkenntnis klar: Größer ist nicht immer besser. Durch das Verständnis der Workload-Anforderungen, langfristigen Kosten und der Vorteile verteilter Systeme können Unternehmen klügere Infrastrukturinvestitionen tätigen, die Widerstandsfähigkeit, Skalierbarkeit und Kosteneffizienz priorisieren.
Sardina Systems, in Zusammenarbeit mit Vespertec, hilft Unternehmen bei der Navigation durch diese Entscheidungen und stellt sicher, dass sie das Infrastrukturmodell übernehmen, das ihre operativen Ziele und langfristiges Wachstum am besten unterstützt. Kontaktieren Sie uns noch heute für eine kostenlose Beratung mit unseren technischen und Produkt-Teams.