


了解如何为人工智能工作负载改造云基础设施:从节约成本到节省资源。
本文是 Spiceworks 上发表的一篇文章的副本。 单击此处阅读原文。
萨迪纳系统公司(Sardina Systems)执行董事兼多语种技术领导人肯尼思-谭(Kenneth Tan)博士深入探讨了企业将人工智能巧妙融入其运营的日益必要性,并就构建强大的人工智能基础设施以充分释放其在业务创新和效率方面的潜力提出了战略性见解。
近年来,人工智能(AI)的迅速发展给商业世界带来了革命性的变化,对人工智能能力的需求往往超越了现有的组织战略。 这促使企业寻求将人工智能融入运营的有效方法。
如何以及从哪里开始建设人工智能基础设施,着眼于长期战略以最大限度地发挥人工智能的潜力?
企业正越来越多地利用人工智能实现部门自动化,并将新的人工智能功能集成到其应用程序中。 麦肯锡的研究显示,自2017年以来,人工智能的采用率显著提高,尽管如此,人工智能工具的应用在很大程度上仍以个人使用和 日常优化为主。
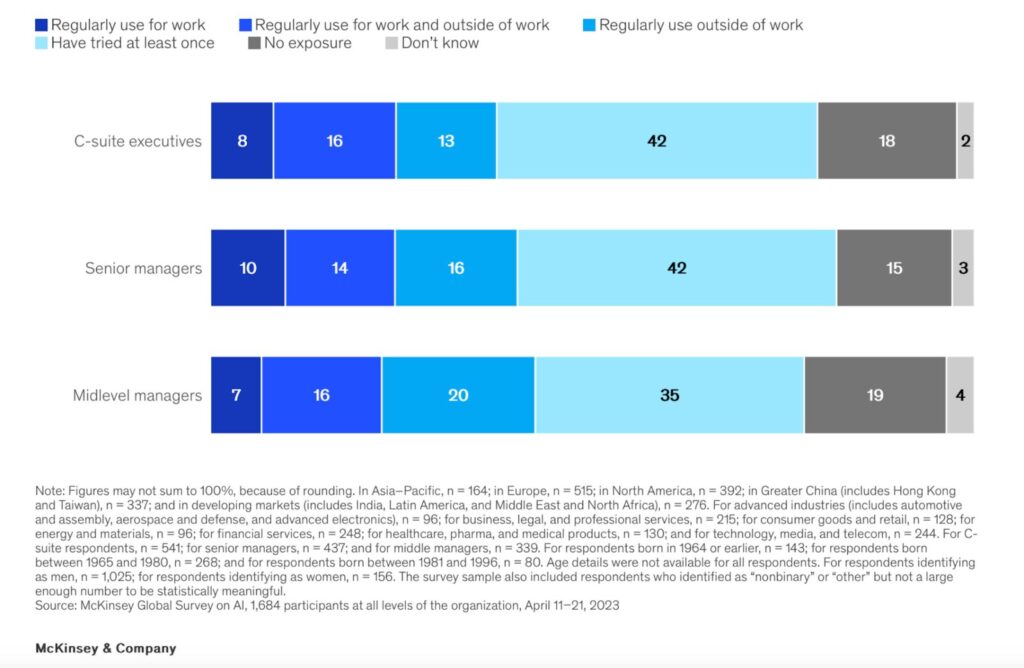
与此同时,人工智能正在企业层面迅速发展。 我们的客户,包括提供人工智能服务的企业和将人工智能嵌入其产品的企业,都说明了市场对易于集成的人工智能工具和创新服务的需求,例如为研究人员提供计算资源。
这篇文章既针对服务提供商,也针对产品集成商,强调了精心规划、可扩展的 IT 基础设施的重要性,以避免不必要的开支和因快速发展的技术而过时。 要开始人工智能基础设施整合之旅,就必须了解当前的能力,并针对未来需求进行战略规划。 我们概述了有效驾驭这一过程的五个基本步骤。
1.当前基础设施评估
对云计算和整体 IT 基础设施采取战略性方法势在必行。
变革,尤其是核心 IT 基础设施的变革,需要对业务模式和预期工作量进行全面评估,也许需要提前数年进行评估,这凸显了在人工智能时代进行缜密规划的极端重要性。
这一转变的第一步涉及对当前的 IT 基础设施进行深入评估,找出与人工智能要求相关的优势、劣势和差距。
评估应包括硬件(如服务器、存储、网络)、软件(如数据库、应用平台)和现有数据管理实践。
了解 IT 基础设施的现状对于规划必要的升级或变更以采用人工智能至关重要。
传统上,有几种概念和框架可以帮助企业评估其 IT 基础设施。
利用这些方法可以为评估 IT 系统的有效性、效率、安全性以及与业务目标的一致性提供结构化方法:
- 在这些经典方法中,ITIL(信息技术基础设施库)尤为重要,因为人工智能的整合应与业务战略紧密结合。 ITIL 由英国政府开发并定期更新,为 IT 服务管理提供了一个详细的框架,使 IT 服务与业务需求保持一致,涵盖服务设计到改进。 它鼓励采用灵活的 IT 管理方法,其中 ITIL 4 取得了重大进展。 将管理与技术相结合至关重要;仅仅关注技术可能会忽略更广泛的影响,尤其是在人工智能集成方面。
- 另一个相关框架是信息系统审计与控制协会的 COBIT,它为企业 IT 管理和治理提供了一个全面的框架,确保与业务目标、风险管理和性能优化保持一致。 利用 COBIT 可确保 IT 升级提高效率,并与自动化和管理的最佳实践保持一致。
2.计算能力和高性能处理器
人工智能,尤其是深度学习,需要具有强大计算能力的处理器,如图形处理器(GPU)、张量处理单元(TPU)或现场可编程门阵列(FPGA)。
硬件市场正处于不断发展的状态,为人工智能设计的新型处理器和加速器在全球范围内层出不穷。
最近的创新产品之一就是高迪3处理器。
虽然贸然采用新产品可能为时过早,但密切关注市场、随时了解新的解决方案并深入探索这一领域无疑是至关重要的。
需要考虑的关键问题包括:这些新产品在质量上有何不同,哪些软件能够支持此类基础设施,以及新的解决方案能否解决您的系统当前面临的挑战。
GPU 因其广泛的商业可用性和高性能而成为当今最流行的选择。
在为人工智能基础架构选择 GPU 时,必须考虑工作负载的具体要求。
这包括确定重点是训练还是推理、评估模型的大小和复杂程度、考虑预算限制以及评估软件生态系统。
英伟达™(NVIDIA®)的图形处理器,尤其是 A100、H100 或 H200,因其性能、全面的软件支持和专业的人工智能加速功能而备受业界青睐。
尽管如此,AMD 和英特尔正日益成为可行的替代方案,尤其是在其独特功能或成本效益具有明显优势的应用场景中。
另一个关键考虑因素是根据工作负载需求扩展资源的能力。
在人工智能模型开发和部署的各个阶段,这种可扩展性对于管理成本和保持效率至关重要。
为了说明可扩展性在人工智能运营中的关键作用,请考虑一下大型电子商务平台面临的常规季节性需求。
亚马逊利用人工智能优化其运营的各个方面,包括库存管理、个性化推荐和物流。
在 “黑色星期五 “或 “网络星期一 “等购物高峰期,亚马逊系统的需求会急剧增加。
为了应对这种情况,亚马逊利用可动态扩展资源的云计算平台。
这种可扩展性对于处理增加的流量和成本管理至关重要。
亚马逊只在需要时才扩大资源规模,并在需求减弱时缩减资源规模,因此可以在不牺牲性能的情况下有效管理成本。
这种方法可确保基础设施不会在非高峰期利用率不足,而在高需求期负担过重,从而保持最佳平衡,支持人工智能驱动的持续创新和客户满意度。
3.大容量存储和管理
人工智能系统需要存储和管理大量数据的能力。
这就需要快速、可扩展的存储解决方案,例如用于非结构化数据的对象存储和用于结构化数据的高性能数据库。
要有效地训练人工智能模型,就必须快速、可靠地访问这些数据。
要做到这一点,可能需要利用先进的数据缓存、部署高带宽网络和实施高效的数据检索系统。
Ceph 作为一种存储解决方案,在处理海量数据方面体现了灵活性和高效性。
它可确保与现有应用程序的兼容性,并促进与云平台的集成,使其成为一种具有成本效益的解决方案。
此外,Ceph 还能大大降低企业数据存储的相关费用,并支持企业管理指数级数据增长。 通过在商品服务器硬件上运行,Ceph 可通过其自我管理和自我修复功能降低资本支出(CapEx)和运营支出(OpEx)。
另一种高效提供海量数据存储和大容量的方法是使用织物上的 NVMe(NVMe-oF)。 它不是单一制造商的产品,而是一个标准,不同公司可以利用它来创建自己的产品和解决方案。
NVMe over Fabrics(NVMe-oF)可极大地帮助构建功能强大、经济高效的数据存储系统,尤其是在需要高性能和可扩展性的情况下。 NVMe-oF 利用了 NVMe SSD 的优势,如通过网络连接的低延迟和高数据传输速度。 这使得远程系统访问数据的速度几乎与存储设备通过 PCIe 本地连接的速度一样快,非常适合数据库、大型计算工作负载和实时大数据处理等高需求应用。
另一个优势是,通过在网络中添加更多 NVMe 设备,存储系统可以轻松扩展,而不会造成性能损失,从而使企业能够满足不断增长的数据存储需求,而无需对基础设施进行全面改造。
虽然 NVMe 设备可能比传统的 SATA 固态硬盘或 HDD 更昂贵,但使用 NVMe-oF 可以创建更高效、更快速的存储系统。
通过提高每个设备的性能来节省成本,从而减少所需的设备总数,降低维护和能源成本。
4.软件和云平台供应商
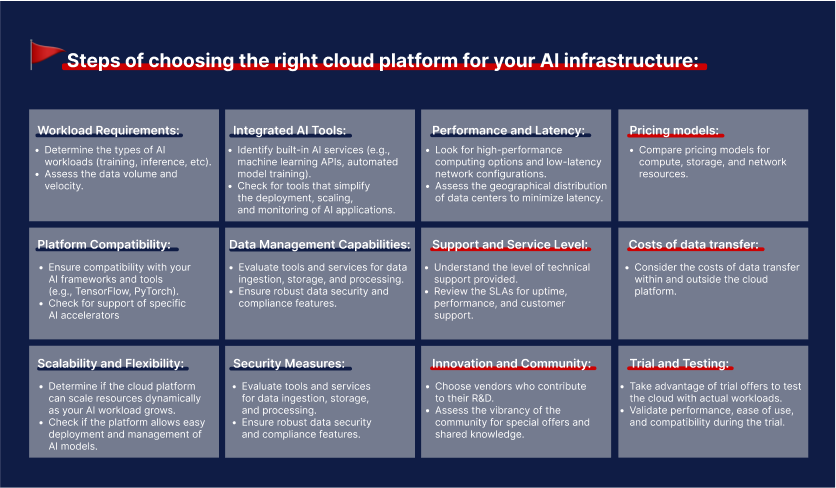
选择合适的云平台或供应商是人工智能基础设施的关键决策。 虽然大多数云平台都能支持人工智能工作负载,但首要考虑的应该是与系统所选处理器的兼容性。 然而,要使基础架构真正有效,仅有这一点是不够的。
人工智能基础设施团队的专业知识对于实现最佳性能至关重要。
尽管云虚拟化非常普遍,但对于人工智能系统来说,它未必总是最佳选择。
如一个案例所示,云、虚拟化和裸机的混合模式可以有效满足深度学习的需求,将计算能力分布与高性能裸机访问融为一体。
因此,供应商必须准确了解系统的目标,才能定制出最有效的云技术解决方案。
其中一家金融组织摩根大通(JPMorgan Chase)面临着处理海量数据以进行实时金融分析和风险管理的挑战。
摩根大通认识到传统云虚拟化对其特定人工智能工作负载的局限性,因此采用了混合云基础设施,将云、虚拟化和裸机解决方案结合在一起。
这种混合模式使摩根大通能够利用云和虚拟化的灵活性来实现可扩展性和成本效益,同时还能利用裸机服务器的强大功能来处理计算密集型人工智能任务。
裸机服务器可直接访问硬件资源,绕过了虚拟化带来的开销,这对于金融建模和风险评估中使用的深度学习算法的性能密集型要求至关重要。
基础架构必须足够灵活,以适应不断变化的人工智能需求,从而能够在最少中断的情况下融入新技术并调整或扩展资源。
许多云提供商提供的人工智能和机器学习服务可以集成到人工智能基础设施中,为模型开发、训练和部署提供强大的工具。
用于虚拟化的 OpenStack 和用于容器化的 Kubernetes 等技术在管理人工智能应用方面发挥着至关重要的作用。
它们简化了人工智能工作负载在不同环境中的部署、扩展和运行,提高了基础设施的灵活性和对不断变化的需求的响应能力。
5.能源效率和消耗
将人工智能融入 IT 基础设施可提高数据处理和算法执行能力,但也会引发能耗问题,尤其是对于需要大量计算能力的深度学习模型而言。 能源部分是最具挑战性的方面,因为提高能效的传统策略包括重新分配负载和关闭未使用的容量。
然而,在人工智能的背景下,关闭机器可能特别具有挑战性,而且可能只能稍微提高能效。
因此,最好把重点放在平衡性能以及识别和管理基础设施中能耗最大的组件上。
在人工智能基础设施中,这些通常是 GPU、FPGA 和其他需要持续冷却或散热的硬件组件。
如果直接优化能源使用被证明是困难的,那么通过提高冷却系统的效率仍然可以节省大量能源。
例如,冰岛的 Borealis 或 atNorth 等数据中心就说明了一种有效的能源管理方法。
利用冰岛凉爽的气候和丰富的可再生能源,这些数据中心利用自然冷却和地热能源,大大减少了对人工制冷的需求,从而降低了人工智能基础设施的总体能耗。
不过,在冰岛运营也会遇到一些挑战,尤其是由于地处偏远,网络延迟和连接性方面的挑战更大。
因此,谨慎选择工作负载类型和在这些数据中心执行项目的时间是明智之举。
对延迟不太敏感的工作负载或那些可以安排在非高峰时段的工作负载可以优化能源使用和网络性能,充分利用冰岛的独特环境,同时减少潜在的弊端。
这种战略方法强调了深思熟虑的基础设施规划对于最大限度地提高人工智能运营的性能和能效的重要性。
探索提高能效的另一种方法是高能效 GPU 和 TPU,以及通过模型剪枝和量化来优化人工智能算法,这是降低能耗同时保持性能的关键。 半导体和人工智能加速器的技术进步也有助于降低功耗。

此外,采用绿色数据中心技术、利用虚拟化和云计算,以及采用动态扩展和人工智能驱动的资源管理,可根据需求调整资源使用,从而提高人工智能运营的能效。 这可确保在不牺牲性能的情况下,高效利用整个 IT 基础设施的能源。
总之,对于旨在利用创新和获得竞争优势的企业来说,改造 IT 基础设施使其为人工智能做好准备至关重要。 优先增强数据、投资专用硬件、集成强大的云解决方案、确保网络安全以及培养一支技术熟练的团队,这些都是为有效部署人工智能和未来技术进步奠定基础的基本步骤。 这些努力可确保成功实施人工智能,并灵活适应新出现的人工智能进步和机遇。
如果您在改造云基础设施方面需要专家协助,请单击此处与我们的团队预约免费咨询。 我们始终致力于帮助企业充分利用其云基础设施。