
Da Unternehmen zunehmend auf softwaredefinierte Infrastrukturen umsteigen, hat sich Ceph als bevorzugte Lösung für den Aufbau skalierbarer, widerstandsfähiger Speichersysteme etabliert. Doch für viele IT-Verantwortliche bleibt die Frage: Kann man mit Ceph klein anfangen und später erweitern, ohne auf architektonische oder betriebliche Hindernisse zu stoßen?
Dies ist mehr als eine theoretische Überlegung. In den heutigen budgetbewussten IT-Umgebungen implementieren Unternehmen Speichersysteme oft phasenweise. Doch die ersten Entscheidungen – Festplattengröße, Speicherprofil und Knotendichte – führen oft zu architektonischen Engpässen, die nur mühsam und kostspielig zu beheben sind.
Für viele Organisationen ist ein kleiner Start mit Ceph eine praktische und kostengünstige Wahl. Ein 3-Knoten-Cluster bietet eine solide Grundlage und erfüllt die Mindestanforderungen für den Betrieb eines voll funktionsfähigen, redundanten Systems unter Verwendung des Replica-3-Modells, das drei Kopien jedes Objekts über die Knoten verteilt speichert.
Doch während dieses Setup kurzfristig gut funktioniert, birgt es langfristige Kompromisse, die zukünftiges Wachstum erschweren können. Mit der Erweiterung der Infrastrukturen wächst die Herausforderung, Leistung, Ausfallsicherheit und betriebliche Einfachheit aufrechtzuerhalten, erheblich.
In diesem Artikel werden wir die wichtigsten Überlegungen untersuchen, die Systemarchitekten berücksichtigen müssen, wenn sie die Skalierung von Ceph-Clustern planen: von der Anzahl der Knoten und Erasure Coding bis hin zu Hardware-Dichte und Datenwiederherstellungsstrategien.
Kann man Ceph also klein anfangen?
Eine der häufigsten Fragen von Infrastrukturteams ist, ob sie mit einem minimalen Cluster, wie z.B. drei Knoten, beginnen und später skalieren können. Die kurze Antwort ist ja, aber nur, wenn Sie bereit sind, von Anfang an wie ein Scale-up zu denken.
Der Unterschied zwischen diesen beiden Optionen offenbart eine wichtige Erkenntnis: größere Festplatten bedeuten nicht nur mehr Kapazität, sondern auch längere Wiederherstellungszeiten im Fehlerfall. Die Festplattengröße ist der Punkt, an dem es interessant und kontrovers wird.
Einerseits bieten größere Festplatten (ab 20 TB) eine höhere Dichte und geringere Kosten pro Terabyte. Andererseits bieten kleinere Laufwerke (10–16 TB) eine schnellere Wiederherstellung, mehr OSDs und eine bessere Leistung unter bestimmten Fehlerszenarien.
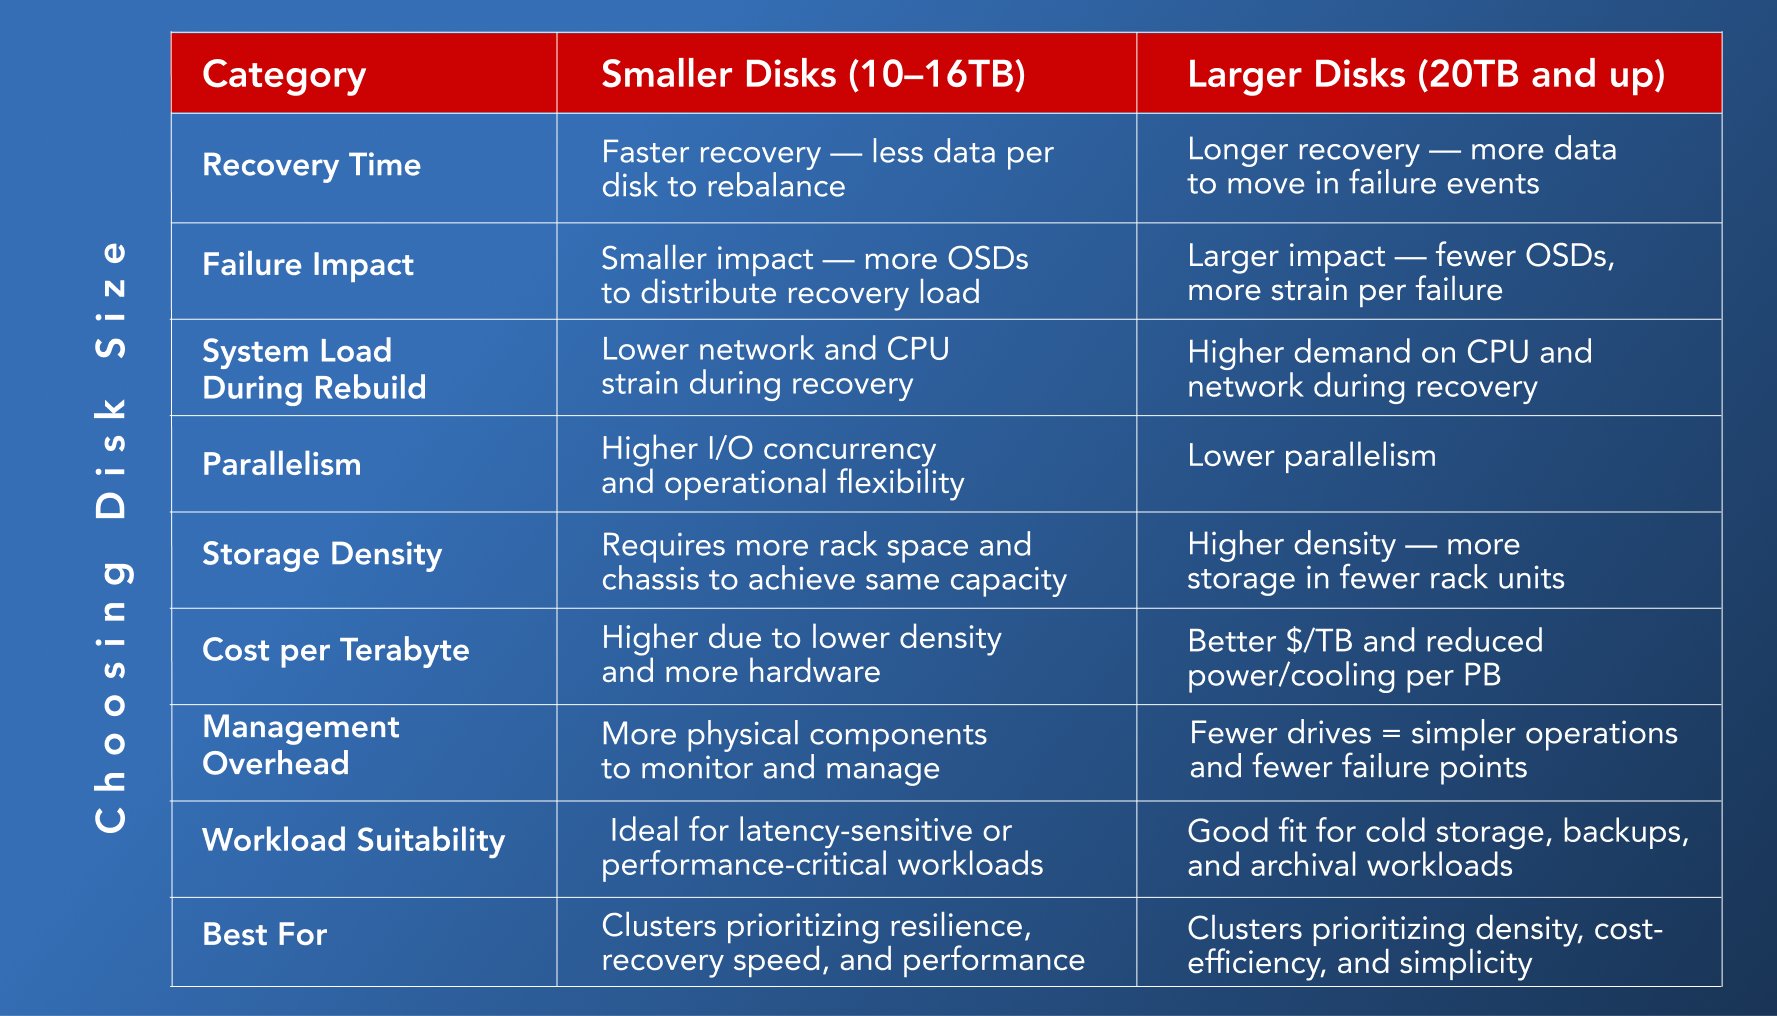
Kleine vs. große Festplatten in Ceph: Vergleich und Anwendungsfälle
Größere Festplatten bringen Wiederherstellungsverzögerungen mit sich. Ein ausgefallenes 20-TB-Laufwerk kann Stunden, sogar Tage für das Rebalancing benötigen, insbesondere in einem ausgelasteten Netzwerk. Und die Auswirkungen sind größer: mehr betroffene Daten, weniger OSDs zur Lastverteilung. Wenn Ihre Workloads latenzempfindlich sind – zum Beispiel VM-Speicher oder Kubernetes – können große Festplatten zu Ihrem Wiederherstellungsengpass werden. Kleinere Festplatten hingegen bieten eine elegante Degradation und schnellere Wiederherstellung.
Was ist also die richtige Wahl? Wenn Ausfallsicherheit und Leistung entscheidend sind, sind kleinere oder mittelgroße Festplatten die bessere Wahl. Sie erholen sich schneller und skalieren mit weniger Aufwand. Wenn Ihre oberste Priorität Dichte und Infrastruktureffizienz ist und Sie in schnelle Netzwerke (25–100GbE) und ausreichend CPU-Overhead investieren können, dann sind größere Festplatten eine praktikable Option, vorausgesetzt, Sie verwalten Fehlerdomänen sorgfältig.
Festplattengröße in Ceph: Abwägung von Dichte, Kosten und betrieblichen Aspekten
Beim Entwurf eines Ceph-Clusters ist eine der wichtigsten Entscheidungen die Wahl zwischen weniger Festplatten mit hoher Kapazität oder mehr Festplatten mit geringerer Kapazität. Beide Ansätze sind praktikabel, und jeder bietet eigene Vorteile, abhängig von Ihren Zielen hinsichtlich Kosteneffizienz, Dichte und operativer Verwaltbarkeit.
Ein wesentlicher Vorteil größerer Festplatten – wie 20-TB- oder sogar 24-TB-Laufwerke – ist, dass sie geringere Kosten pro Terabyte bieten. Sie erleichtern auch das Erreichen einer hohen Speicherdichte, insbesondere in Umgebungen mit begrenztem Rack-Platz. Dies kann besonders attraktiv sein beim Aufbau großer Cold-Storage-Systeme oder bei der Planung für langfristiges Kapazitätswachstum.
Allerdings bringt physische Dichte auch physisches Gewicht mit sich. HDDs wiegen typischerweise zwischen 0,5 und 0,75 kg pro Stück. In einem hochdichten 4U-Gehäuse mit 90 Laufwerken kann das Gesamtgewicht 100 kg pro Einheit überschreiten. Ein voll bestücktes Rack mit mehreren solcher Einheiten könnte 1.000 kg erreichen oder überschreiten, was innerhalb der Rack-Spezifikationen liegt – aber nicht alle Rechenzentrumsböden sind für diese Last ausgelegt.
Bei der Planung dichter Bereitstellungen ist es wichtig, nicht nur Stromversorgung und Kühlung zu berücksichtigen, sondern auch Bodenbelastbarkeit, strukturelle Integrität und Rack-Spezifikationen. In diesen Umgebungen ist die Festplattendichte nicht nur eine Frage der Kapazität oder der Kosten – sie ist eine Frage der Infrastrukturbereitschaft.
Die Festplattengröße spielt jedoch auch im täglichen Betrieb eine Rolle, insbesondere bei der Planung von Routineprozessen wie dem Scrubbing oder dem Umgang mit Hardwarefehlern.
Cephs Scrubbing-Mechanismus, der die langfristige Datenintegrität durch die Überprüfung auf Bit-Rot oder stille Korruption sicherstellt, wird mit größeren Laufwerken ressourcenintensiver. Da es sich um eine Hintergrundaufgabe handelt, die CPU und Arbeitsspeicher nutzt, skaliert die Dauer des Prozesses mit der Festplattenkapazität.
Ähnlich verhält es sich im Falle eines Knoten- oder Festplattenausfalls: Die Menge der Daten, die neu ausbalanciert oder wiederhergestellt werden müssen, ist bei größeren Laufwerken naturgemäß höher. Dies stellt an sich kein Problem dar, ist aber eine betriebliche Überlegung, die bei der Dimensionierung von Rechenressourcen, der Planung des Netzwerkdurchsatzes oder der Schätzung von Wiederherstellungszeiten berücksichtigt werden sollte.
Zur Veranschaulichung:
- Ein Knoten mit 102x10TB HDD-Festplatten hätte im Fehlerfall 1,02 PB Rohkapazität zum Rebalancing.
- Derselbe Knoten mit 102 x 20-TB-Festplatten müsste im Fehlerfall 2,04 PB für das Rebalancing verarbeiten.
Das bedeutet nicht, dass ein Ansatz besser ist als der andere – vielmehr geht es darum, die Hardware-Auswahl an Ihre betrieblichen Erwartungen anzupassen:
- Wenn Sie Kosten pro PB und Rack-Effizienz priorisieren, sind große Festplatten eine gute Option.
- Wenn schnellere Wiederherstellungen und geringere Auswirkungen pro Festplatte kritischer sind, könnte eine Strategie mit kleineren Festplatten besser für Sie geeignet sein.
Letztendlich sind beide Wege gültig, und eine frühzeitige Planung dieser Nuancen führt zu einer widerstandsfähigeren und effizienteren Ceph-Bereitstellung.
JBODs: kostengünstig, skalierbar und kein Cheat-Code
Im Wettlauf um die Speicherskalierung, ohne das Budget zu sprengen, sind JBODs – Just a Bunch of Disks – zu einer verlockenden Option geworden. Und in vielen Fällen zu Recht.
Ein JBOD ist ein Festplattengehäuse, das mit einzelnen Laufwerken gefüllt ist, die nicht zu einem RAID-Array zusammengefasst sind. Stattdessen werden sie dem Host-Betriebssystem oder der softwaredefinierten Speicherschicht (wie Ceph, ZFS oder Software-RAID) als unabhängige Geräte präsentiert. Das bedeutet, dass Redundanz, Fehlertoleranz und Wiederherstellung in der Software und nicht in der Hardware liegen.
In Ceph-Bereitstellungen werden JBODs typischerweise verwendet, um die Speicherkapazität des Servers zu erweitern, an den sie direkt angeschlossen sind – nicht als eigenständige Appliances. Dieses Modell passt gut zur Ceph-Architektur, bei der der Server die Logik und das JBOD die Rohfestplattenkapazität bereitstellt. Es geht nicht nur um Kosteneinsparungen – es geht darum, den Speicher effizient und kompakt zu erweitern, indem Gehäuse verwendet werden, die eine große Anzahl von Laufwerken aufnehmen können.
Für viele Teams, die Ceph oder andere Objektspeichersysteme aufbauen, sind JBODs sinnvoll. Sie können mit einem teilweise gefüllten Gehäuse beginnen und Laufwerke nach Bedarf hinzufügen. Es ist nicht nötig, Hardware im Voraus überzudimensionieren. Es ist ein Modell, das CapEx reduziert und die vollständige Investition verzögert, bis der Speicherbedarf dies rechtfertigt.
Natürlich erfordert es, wie bei jeder Infrastrukturkomponente, eine sorgfältige Planung, um das Beste aus JBODs herauszuholen. Redundanz, Zuverlässigkeit und Wiederherstellbarkeit müssen integriert sein.
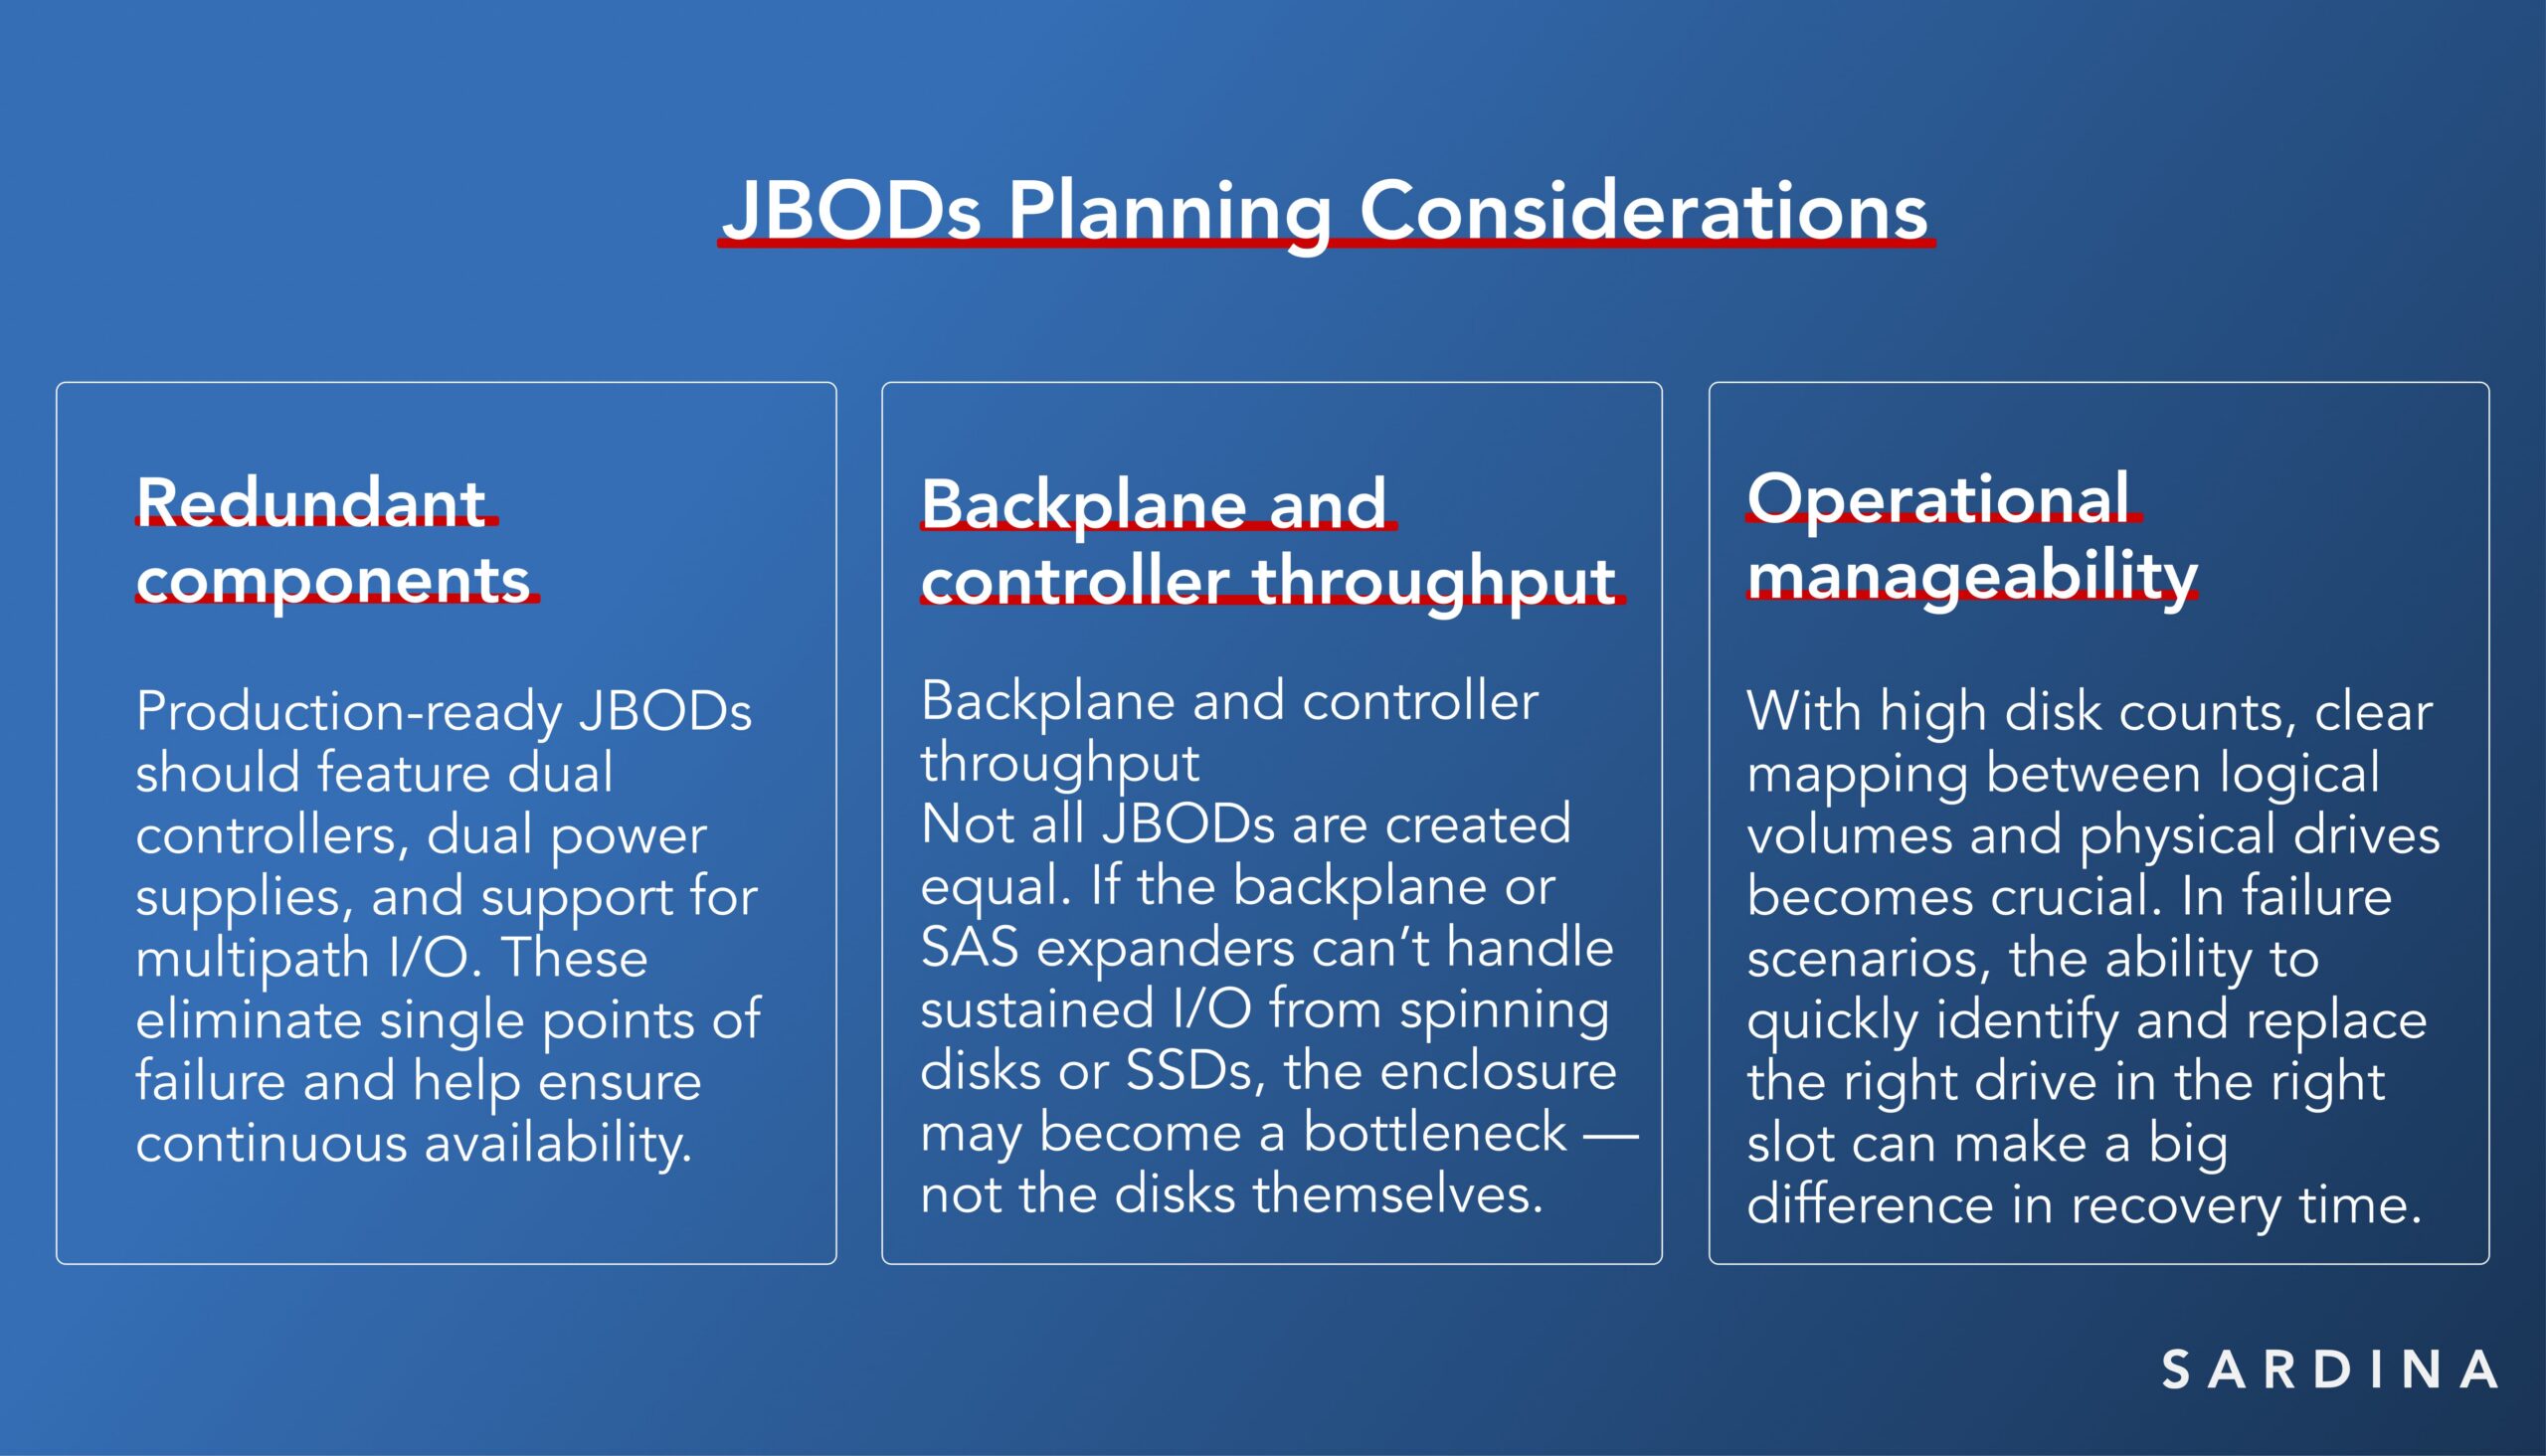
Bei richtiger Integration in eine Ceph-basierte Architektur bieten JBODs einen eleganten, effizienten Weg zu großskaligem Speicher, insbesondere für Workloads wie Backup, Archivierung, Medienbibliotheken und Forschungsdaten-Lakes.
Anstatt sie als Kompromiss zu betrachten, ist es genauer, JBODs als Werkzeug im Baukasten des Architekten zu sehen. Mit dem richtigen Design können JBOD-basierte Cluster Leistung, Zuverlässigkeit und Kosteneffizienz im großen Maßstab liefern.
Replica vs. Erasure Coding: Eine unwiderrufliche Entscheidung
Ceph bietet Ihnen Auswahlmöglichkeiten, aber einige dieser Entscheidungen sind Einbahnstraßen. Im Mittelpunkt dieses Kompromisses steht die Wahl zwischen Replikation und Erasure Coding (EC) als Speicherrichtlinie.
- Replica-3 speichert drei Kopien jedes Datenblocks über verschiedene Knoten hinweg und bietet Einfachheit sowie hohe Leistung, insbesondere für kleine I/O-Operationen.
- Erasure Coding teilt Daten in Daten- und Paritäts-Chunks auf, was die Wiederherstellung nach zwei beliebigen Ausfällen ermöglicht und gleichzeitig weniger Gesamtkapazität verbraucht. EC 3+2 ist nur eine der gängigsten Erasure-Coding-Konfigurationen, die Ceph unterstützt. Abhängig von Ihrer Risikotoleranz, Leistungszielen und nutzbaren Kapazitätszielen können alternative Profile wie EC 4+2, 6+3 oder 8+4 eine bessere Abstimmung bieten.
Aber hier ist der Haken: Sobald Sie einen Speicherpool mit Replica-3 eingerichtet haben, erfordert ein Wechsel zu beispielsweise EC 3+2 Ausfallzeiten. Die Migration umfasst einen
Das bedeutet, dass Ihr Datenhaltbarkeitsmodell nicht nur eine technische Wahl ist – es ist eine Verpflichtung. Wenn Sie planen, mit Replica-3 zu beginnen und später für eine bessere Speichereffizienz auf EC umzusteigen, müssen Sie mit einem geplanten Wartungsfenster und den damit verbundenen Risiken rechnen.
Budget vs. Ausfallsicherheit: Der Balanceakt der Infrastruktur
All diese Entscheidungen – Replikationsstrategie, Festplattengröße, Knotendesign und Gehäusewahl – laufen auf eine zentrale Spannung hinaus: das heutige Budget mit der Ausfallsicherheit von morgen in Einklang zu bringen. Infrastrukturarchitekten müssen sich fragen:
- Können wir uns später Ausfallzeiten leisten, wenn wir jetzt Kompromisse eingehen?
- Wird die Hardware, die wir heute kaufen, unsere Optionen in 12 Monaten einschränken?
- Entwerfen wir für den Fehlerfall oder hoffen wir nur, dass er nicht eintritt?
Dies sind keine theoretischen Fragen. Sie wirken sich direkt auf Beschaffungsfristen, Kapazitätsplanung und letztendlich auf die Benutzererfahrung aus.
Wichtige Erkenntnisse: Was jeder Ceph-Käufer wissen sollte
Für viele Organisationen sind die wichtigsten Erkenntnisse klar:
- Ja, Sie können mit drei Knoten beginnen, aber planen Sie sorgfältig. Wenn Sie in Zukunft EC benötigen, akzeptieren Sie, dass die Migration Ausfallzeiten und operativen Aufwand erfordert.
- Entwerfen Sie, wenn möglich, von Anfang an mit fünf Knoten. Selbst ein bescheidenes 5-Knoten-EC-3+2-Setup kann eine bessere Speichereffizienz und einfachere Wiederherstellung bieten, ohne Ihren Rack-Platzbedarf erheblich zu erhöhen.
- Denken Sie nicht nur an Kapazität – denken Sie an den Fehlerfall. Ein gut ausbalancierter Ceph-Cluster optimiert CPU, RAM, Festplattengröße und Fehlerdomäne.
Ceph ist unglaublich flexibel, aber Flexibilität bedeutet nicht, dass Sie auf die Architekturplanung verzichten können. Ihre zu Beginn getroffenen Entscheidungen können Kompromisse festlegen, die später teuer oder störend rückgängig zu machen sind. Bevor Sie also den ersten Knoten in das Rack einbauen, fragen Sie sich:
- Werde ich Erasure Coding benötigen?
- Wie viele Ausfallzeiten kann ich während der Migration tolerieren?
- Wie schnell soll die Wiederherstellung sein?
- Wie dicht sollen meine Racks sein?
- Muss ich schrittweise erweitern, und wie?
Die Antworten können beeinflussen, wie Sie Ihren Cluster aufbauen und wie reibungslos Ihre Infrastruktur skaliert.