
По мере того как организации все больше переходят к программно-определяемой инфраструктуре, Ceph становится популярным решением для построения масштабируемых и отказоустойчивых систем хранения. Тем не менее, для многих ИТ-руководителей вопрос остается открытым: можно ли начать с малого с Ceph и расширяться позже, не сталкиваясь с архитектурными или операционными препятствиями?
Это больше, чем теоретическое рассуждение. В современных ИТ-средах с ограниченным бюджетом предприятия часто развертывают системы хранения поэтапно. Однако первоначальный выбор — размер диска, профиль хранения и плотность узлов — часто создает архитектурные узкие места, которые болезненно и дорого устранять.
Для многих организаций начать с малого с Ceph — это практичный и экономически эффективный выбор. Кластер из 3 узлов предлагает прочную основу и соответствует минимальным требованиям для запуска полнофункциональной отказоустойчивой системы с использованием модели Replica-3, которая хранит три копии каждого объекта на узлах.
Но хотя эта настройка хорошо работает в краткосрочной перспективе, она сопряжена с долгосрочными компромиссами, которые могут усложнить будущий рост. По мере расширения инфраструктуры задача поддержания производительности, отказоустойчивости и операционной простоты значительно усложняется.
В этой статье мы рассмотрим ключевые аспекты, которые системные архитекторы должны учитывать при планировании масштабирования кластеров Ceph: от количества узлов и erasure coding до плотности оборудования и стратегий восстановления данных.
Итак, можно ли начать с малого с Ceph?
Один из самых распространенных вопросов от инфраструктурных команд заключается в том, могут ли они начать с минимального кластера, например, из трех узлов, и масштабироваться позже. Краткий ответ — да, но только если вы готовы с самого начала мыслить как при масштабировании.
Разница между этими двумя вариантами раскрывает ключевую идею: большие диски — это не просто большая емкость, это еще и более длительное время восстановления в случае сбоя. Размер диска — это то, где все становится интересным и спорным.
С одной стороны, диски большего размера (например, 20 ТБ и выше) обеспечивают лучшую плотность и более низкую стоимость за терабайт. С другой стороны, диски меньшего размера (10–16 ТБ) обеспечивают более быстрое восстановление, больше OSD и лучшую производительность в определенных сценариях сбоев.
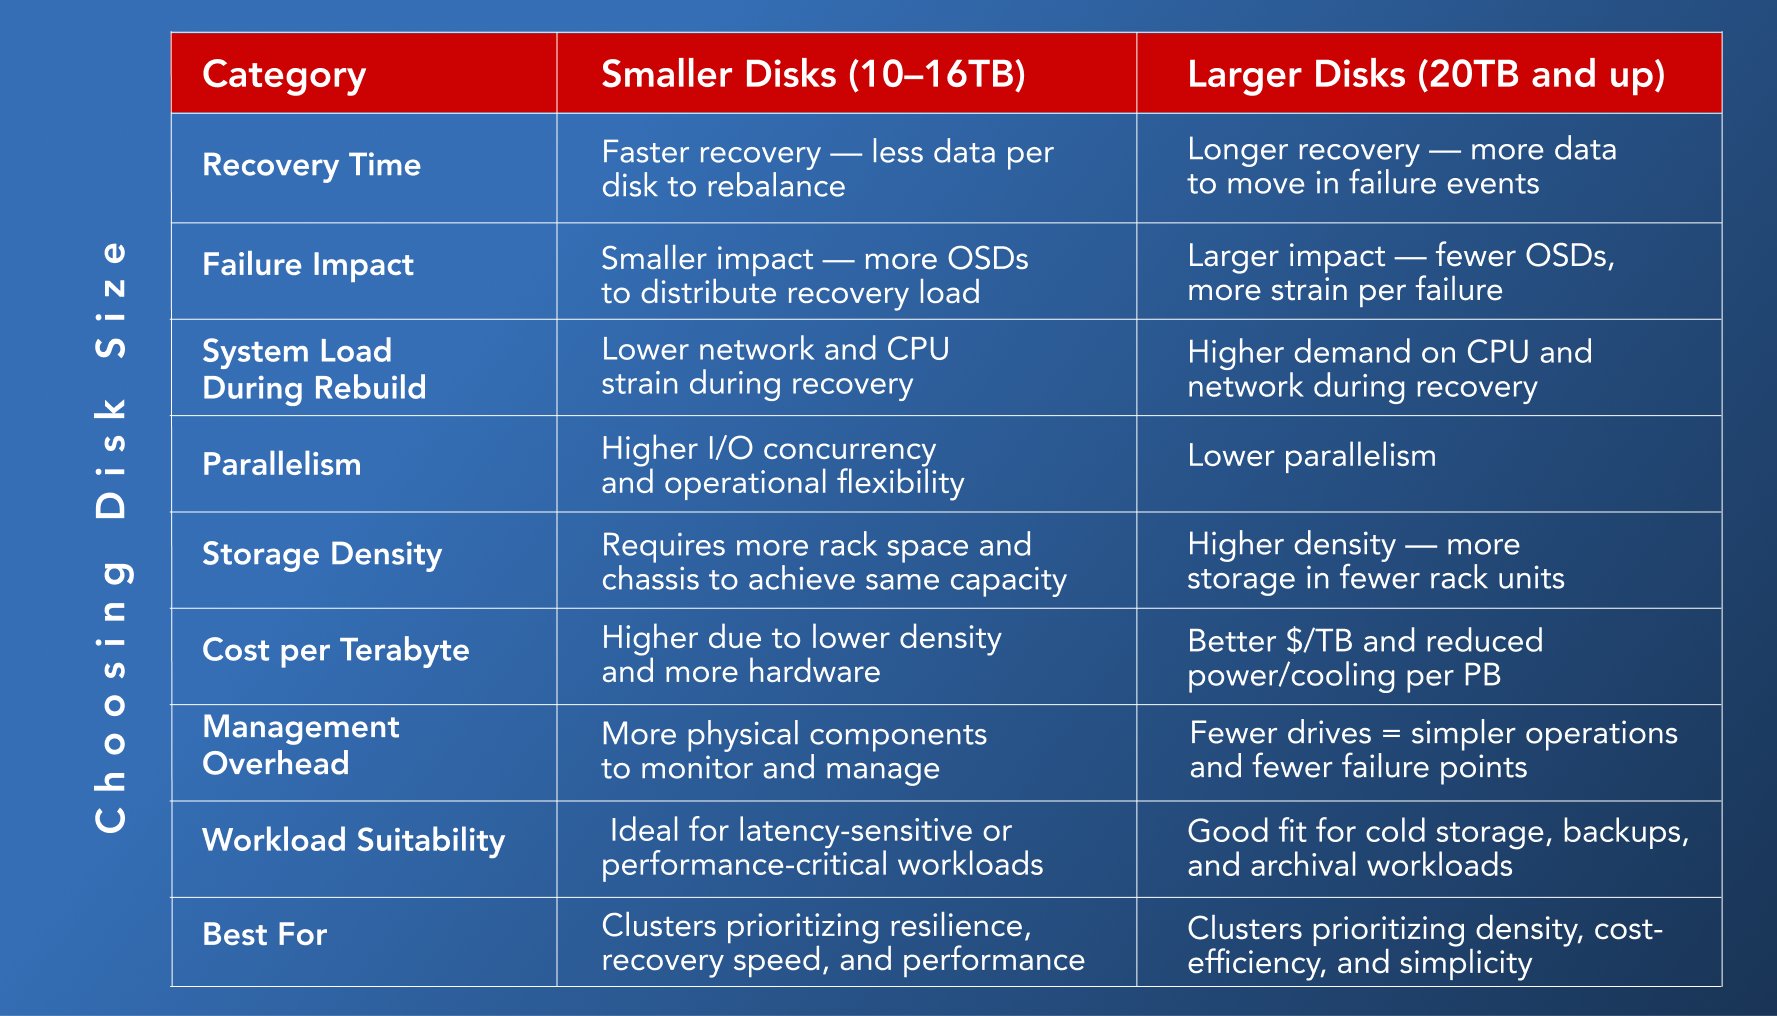
Маленькие и большие диски в Ceph: сравнение и варианты использования
Большие диски сопряжены с задержками восстановления. Восстановление отказавшего диска емкостью 20 ТБ может занять часы и даже дни, особенно в насыщенной сети. И влияние больше: больше данных затронуто, меньше OSD для распределения нагрузки. Если ваши рабочие нагрузки чувствительны к задержкам — например, хранилище виртуальных машин или Kubernetes — большие диски могут стать узким местом при восстановлении. Диски меньшего размера, с другой стороны, обеспечивают плавную деградацию и более быстрое восстановление.
Так какой же выбор правильный? Если отказоустойчивость и производительность являются ключевыми факторами, то выигрывают диски меньшего или среднего размера. Они быстрее восстанавливаются и масштабируются с меньшей болью. Если ваш главный приоритет — плотность и эффективность инфраструктуры, и вы можете инвестировать в быстрые сети (25–100GbE) и достаточный запас ЦП, то диски большего размера вполне жизнеспособны, при условии, что вы тщательно управляете доменами сбоев.
Размер диска в Ceph: баланс плотности, стоимости и эксплуатационных соображений
При проектировании кластера Ceph одним из ключевых решений является выбор между меньшим количеством дисков высокой емкости или большим количеством дисков меньшей емкости. Оба подхода жизнеспособны, и каждый из них имеет свои преимущества в зависимости от ваших целей в отношении экономической эффективности, плотности и эксплуатационной управляемости.
Основным преимуществом дисков большего размера — таких как диски емкостью 20 ТБ или даже 24 ТБ — является то, что они предлагают более низкую стоимость за терабайт. Они также облегчают достижение высокой плотности хранения, особенно в средах с ограниченным пространством в стойке. Это может быть особенно привлекательно при создании крупномасштабных систем холодного хранения или при планировании долгосрочного роста емкости.
Однако физическая плотность также приводит к увеличению физического веса. Жесткие диски обычно весят от 0,5 до 0,75 кг каждый. В корпусе 4U высокой плотности, заполненном 90 дисками, общий вес может превышать 100 кг на единицу. Полная стойка, загруженная несколькими такими устройствами, может приблизиться к 1000 кг или превысить их, что соответствует спецификациям стойки, но не все полы центров обработки данных рассчитаны на такую нагрузку.
При планировании плотных развертываний важно учитывать не только мощность и охлаждение, но и нагрузочную способность пола, структурную целостность и спецификации стойки. В этих средах плотность дисков — это не просто вопрос емкости или стоимости, это вопрос готовности инфраструктуры.
Однако размер диска также влияет на повседневные операции, особенно при планировании обычных процессов, таких как очистка или обработка аппаратных сбоев.
Механизм очистки Ceph, который обеспечивает долгосрочную целостность данных, проверяя наличие битовых ошибок или скрытых повреждений, становится более ресурсоемким с дисками большего размера. Поскольку это фоновая задача, использующая ЦП и память, продолжительность процесса масштабируется с емкостью диска.
Аналогичным образом, в случае сбоя узла или диска объем данных, который необходимо перебалансировать или восстановить, будет, естественно, выше при использовании дисков большего размера. Это само по себе не является проблемой, но это эксплуатационное соображение, которое следует учитывать при определении размера вычислительных ресурсов, планировании пропускной способности сети или оценке окон восстановления.
Для иллюстрации:
- Узел со 102 дисками HDD емкостью 10 ТБ будет иметь 1,02 ПБ необработанной емкости для перебалансировки в случае сбоя.
- Тому же узлу с 102 дисками емкостью 20 ТБ потребуется обработать 2,04 ПБ для перебалансировки в случае сбоя.
Это не означает, что один подход лучше другого — скорее, речь идет о согласовании выбора оборудования с вашими эксплуатационными ожиданиями:
- Если вы отдаете приоритет стоимости за ПБ и эффективности стойки, диски большого размера — отличный вариант.
- Если более быстрая перестройка и меньшее влияние восстановления на диск более важны, вам больше подойдет стратегия с дисками меньшего размера.
В конечном счете, оба пути являются допустимыми, и планирование этих нюансов на раннем этапе приводит к более отказоустойчивому и эффективному развертыванию Ceph.
JBOD: экономичные, масштабируемые и не чит-код
В гонке за масштабирование хранилища без раздувания бюджета JBOD — Just a Bunch of Disks — стали заманчивым вариантом. И во многих случаях вполне заслуженно.
JBOD — это дисковый корпус, заполненный отдельными дисками, которые не сгруппированы в RAID-массив. Вместо этого они предоставляются хост-ОС или программно-определяемому уровню хранения (например, Ceph, ZFS или программному RAID) как независимые устройства. Это означает, что избыточность, отказоустойчивость и восстановление находятся в программном обеспечении, а не в оборудовании.
В развертываниях Ceph JBOD обычно используются для расширения емкости хранилища сервера, к которому они непосредственно подключены, а не в качестве автономных устройств. Эта модель хорошо согласуется с архитектурой Ceph, где сервер обеспечивает логику, а JBOD — необработанную емкость диска. Речь идет не только об экономии затрат, но и об эффективном и компактном расширении хранилища с использованием корпусов, в которых можно разместить большое количество дисков.
Для многих команд, создающих Ceph или другие системы объектного хранения, JBOD имеют смысл. Вы можете начать с частично заполненного корпуса и добавлять диски по мере необходимости. Нет необходимости заранее перегружать оборудование. Это модель, которая снижает капитальные затраты и откладывает полные инвестиции до тех пор, пока спрос на хранилище не оправдает их.
Конечно, как и в случае с любым компонентом инфраструктуры, для получения максимальной отдачи от JBOD требуется продуманное планирование. Необходимо обеспечить встроенную избыточность, надежность и возможность восстановления.
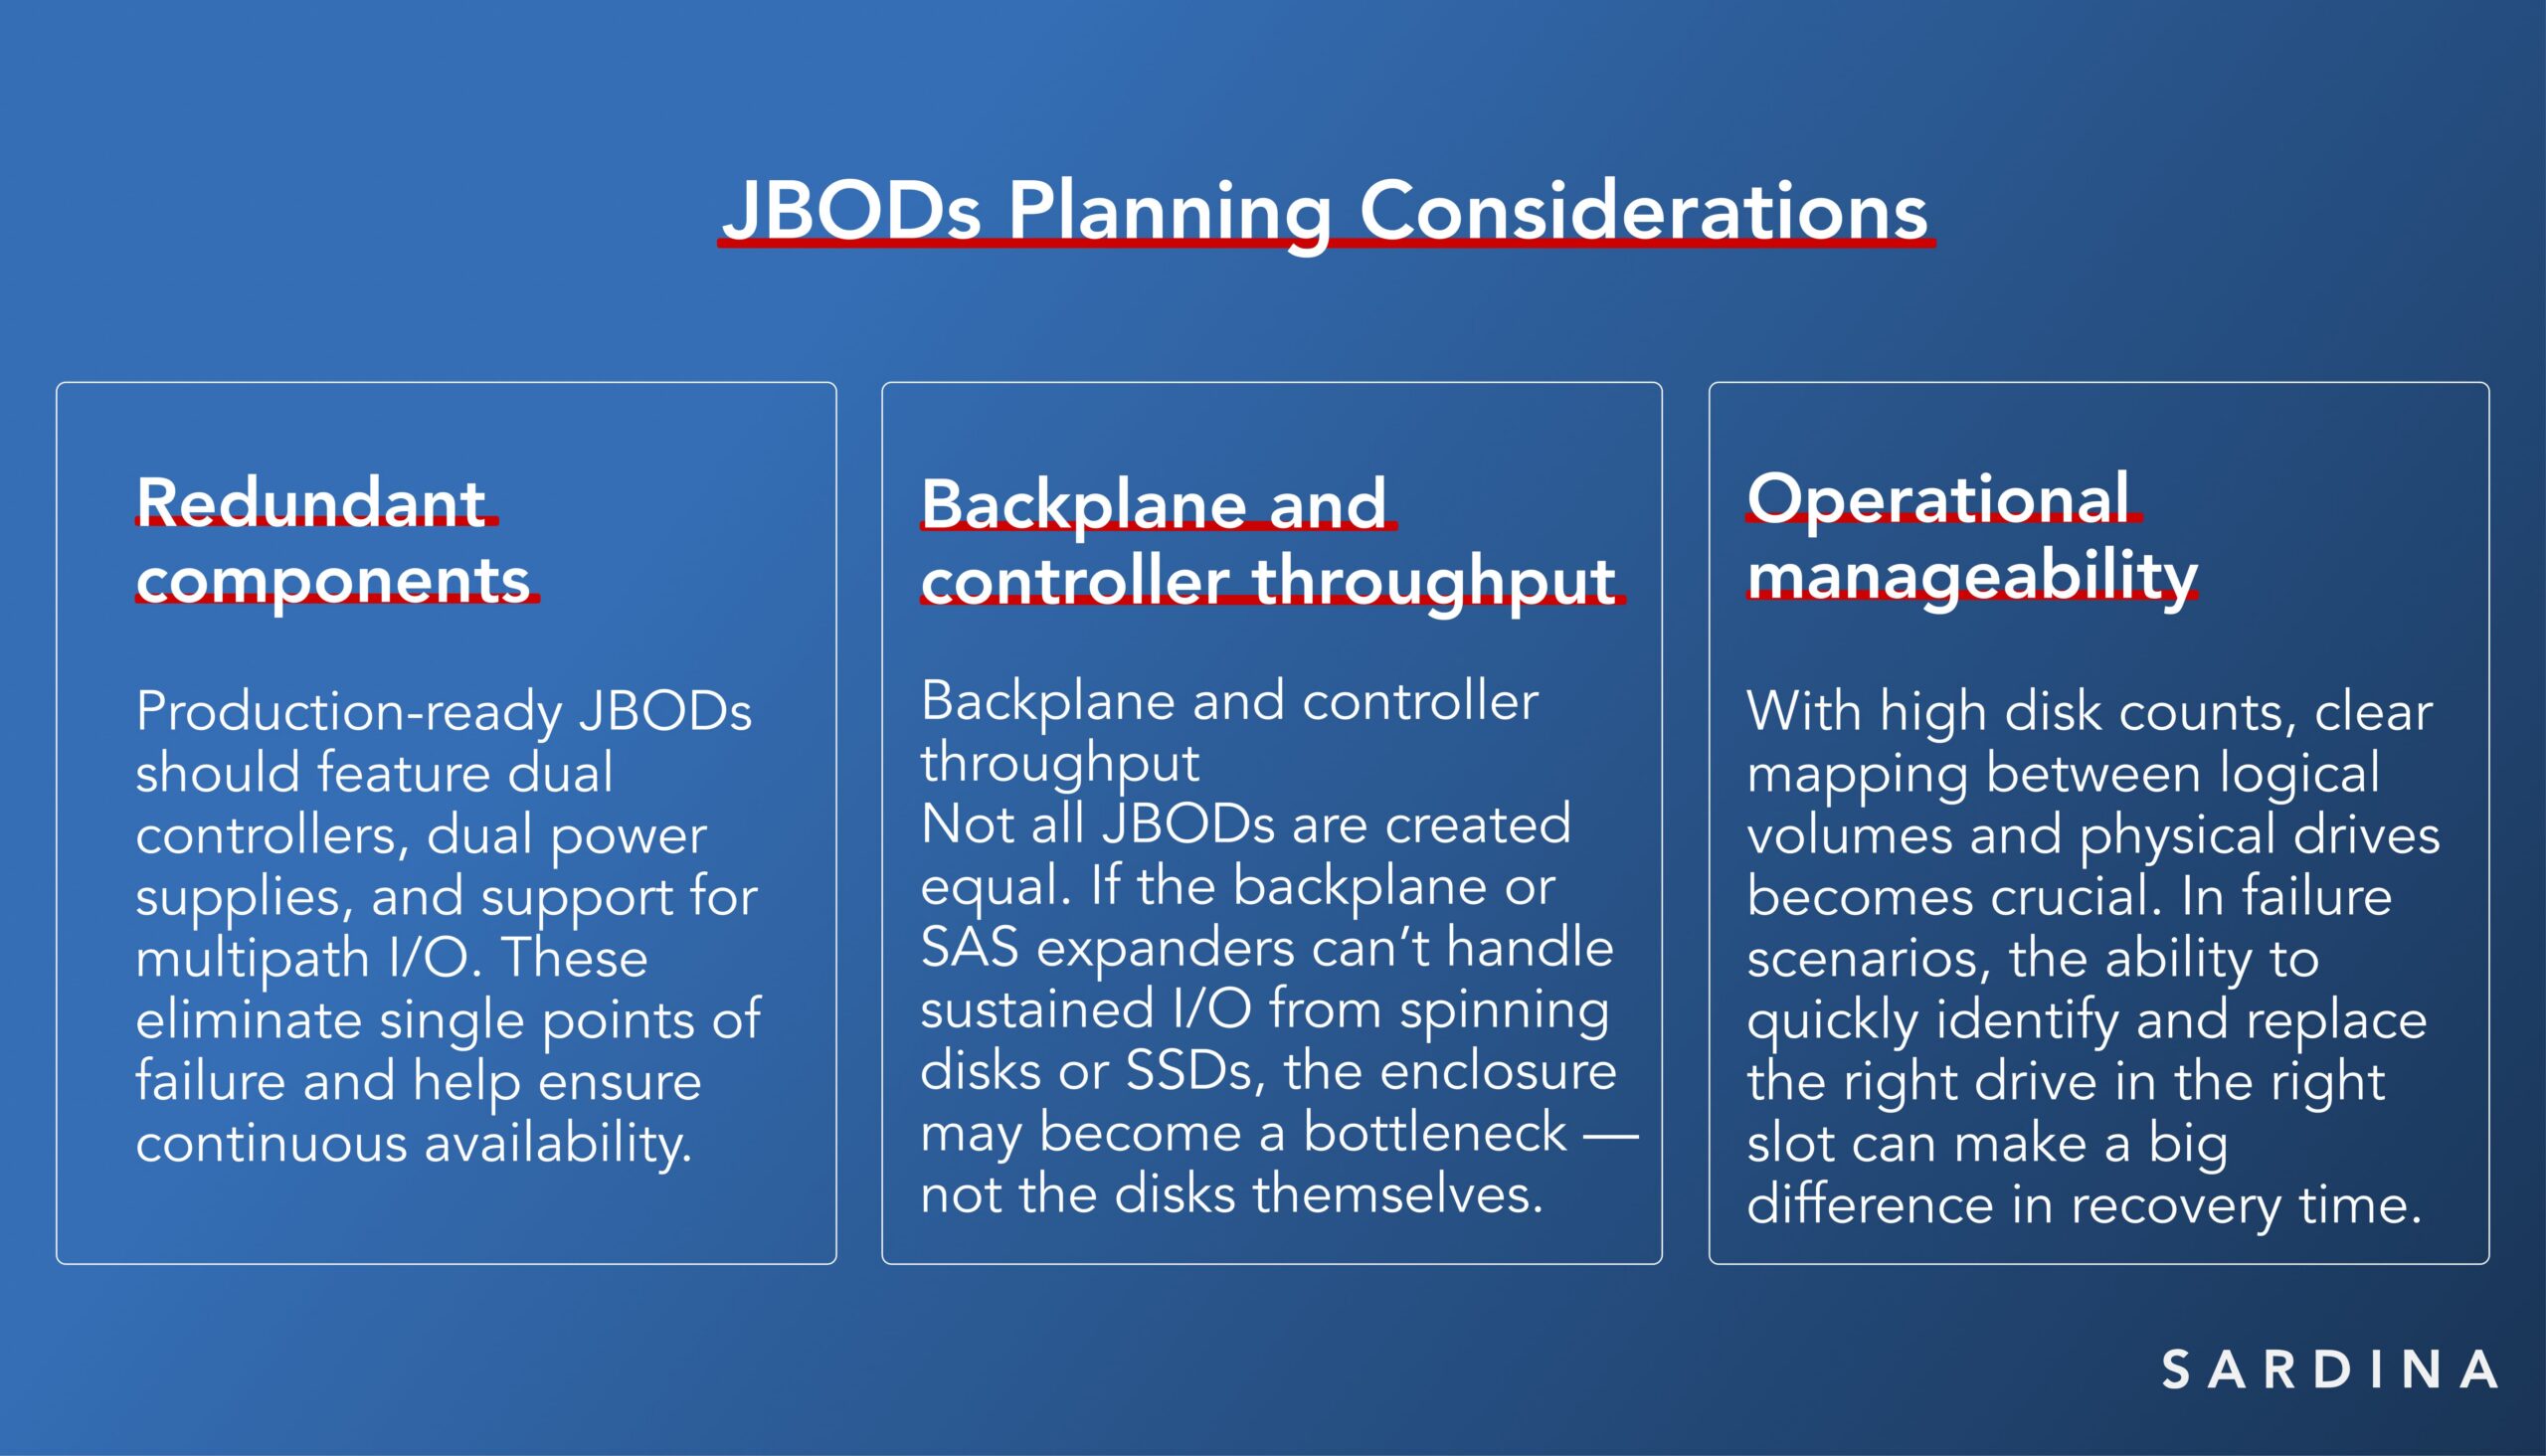
При правильной интеграции в архитектуру на основе Ceph JBOD предлагают элегантный и эффективный путь к крупномасштабному хранилищу, особенно для таких рабочих нагрузок, как резервное копирование, архивирование, медиатеки и озера исследовательских данных.
Вместо того чтобы рассматривать их как компромисс, более точно рассматривать JBOD как инструмент в наборе архитектора. При правильном проектировании кластеры на основе JBOD могут обеспечивать производительность, надежность и экономическую эффективность в масштабе.
Репликация против erasure coding: делаем ставку в одну сторону
Ceph дает вам выбор, но некоторые из этих вариантов — двери в одну сторону. В основе этого компромисса лежит выбор между репликацией и erasure coding (EC) в качестве политики хранения.
- Replica-3 хранит три копии каждого блока данных на разных узлах, обеспечивая простоту и высокую производительность, особенно для небольших операций ввода-вывода.
- Erasure Coding разделяет данные на блоки данных и четности, позволяя восстанавливаться после любых двух сбоев при меньшем общем использовании емкости. EC 3+2 — это лишь одна из наиболее распространенных конфигураций erasure coding, поддерживаемых Ceph. В зависимости от вашей терпимости к риску, целей производительности и целевых показателей полезной емкости, альтернативные профили, такие как EC 4+2, 6+3 или 8+4, могут предложить лучшее соответствие.
Но вот в чем загвоздка: после того, как вы настроили пул хранения с Replica-3, переключение, например, на EC 3+2 требует простоя. Миграция включает в себя процесс
Это означает, что ваша модель долговечности данных — это не просто технический выбор, это обязательство. Если вы планируете начать с Replica-3 и позже перейти на EC для повышения эффективности хранения, будьте готовы к запланированному окну обслуживания и связанным с этим рискам.
Бюджет против отказоустойчивости: балансировка инфраструктуры
Все эти решения — стратегия репликации, размер диска, конструкция узла и выбор корпуса — сводятся к одному основному напряжению: балансировка бюджета сегодня с отказоустойчивостью завтра. Архитекторы инфраструктуры должны спросить:
- Можем ли мы позволить себе простой позже, если мы срежем углы сейчас?
- Ограничит ли оборудование, которое мы покупаем сегодня, наш выбор через 12 месяцев?
- Проектируем ли мы с учетом сбоев или просто надеемся, что этого не произойдет?
Это не теоретические вопросы. Они напрямую влияют на сроки закупок, планирование емкости и, в конечном счете, на пользовательский опыт.
Выводы: что должен знать каждый покупатель Ceph
Для многих организаций выводы ясны:
- Да, вы можете начать с трех узлов, но планируйте тщательно. Если вы ожидаете, что в будущем вам понадобится EC, примите, что миграция требует простоя и операционных усилий.
- По возможности проектируйте с пятью узлами с самого начала. Даже скромная настройка EC 3+2 с 5 узлами может предложить лучшую эффективность хранения и более простое восстановление без значительного увеличения занимаемой площади в стойке.
- Не думайте только о емкости — думайте о сбоях. Хорошо сбалансированный кластер Ceph оптимизирован для ЦП, ОЗУ, размера диска и домена сбоев.
Ceph невероятно гибок, но гибкость не означает, что вы можете пропустить архитектурное планирование. Решения, принятые в начале, могут зафиксировать компромиссы, которые дорого или разрушительно отменить позже. Поэтому, прежде чем устанавливать этот первый узел, спросите себя:
- Понадобится ли мне erasure coding?
- Какой простой я могу допустить во время миграции?
- Насколько быстрым я хочу, чтобы было восстановление?
- Насколько плотными я хочу, чтобы были мои стойки?
- Нужно ли мне расширяться постепенно, и как?
Ответы могут изменить то, как вы строите свой кластер, и то, насколько плавно масштабируется ваша инфраструктура.