
À medida que as organizações se voltam cada vez mais para infraestruturas definidas por software, o Ceph emergiu como uma solução preferencial para a construção de sistemas de armazenamento escaláveis e resilientes. No entanto, para muitos líderes de TI, a questão permanece: É possível começar em pequena escala com o Ceph e expandir mais tarde sem encontrar obstáculos arquitetónicos ou operacionais?
Isto é mais do que uma consideração teórica. Nos ambientes de TI atuais, conscientes dos orçamentos, as empresas frequentemente implementam sistemas de armazenamento por fases. No entanto, as primeiras escolhas — tamanho do disco, perfil de armazenamento e densidade dos nós — muitas vezes criam estrangulamentos arquitetónicos que são dolorosos e dispendiosos de desfazer.
Para muitas organizações, começar em pequena escala com o Ceph é uma escolha prática e económica. Um cluster de 3 nós oferece uma base sólida e satisfaz o requisito mínimo para executar um sistema totalmente funcional e redundante utilizando o modelo Replica-3, que armazena três cópias de cada objeto através dos nós.
Mas embora esta configuração funcione bem a curto prazo, vem com compromissos a longo prazo que podem complicar o crescimento futuro. À medida que as infraestruturas se expandem, o desafio de manter o desempenho, a resiliência e a simplicidade operacional cresce significativamente.
Neste artigo, exploraremos as considerações fundamentais que os arquitetos de sistemas devem ter em conta ao planear o escalonamento de clusters Ceph: desde o número de nós e a codificação de eliminação até à densidade do hardware e às estratégias de recuperação de dados.
Então, pode começar o Ceph em pequena escala?
Uma das perguntas mais comuns das equipas de infraestrutura é se podem começar com um cluster mínimo, como três nós, e escalar mais tarde. A resposta curta é sim, mas apenas se estiver disposto a pensar como um scale-up desde o primeiro dia.
A diferença entre estas duas opções revela uma perceção fundamental: discos maiores não significam apenas mais capacidade, também significam tempos de recuperação mais longos em caso de falha. O tamanho do disco é onde as coisas se tornam interessantes e controversas.
Por um lado, os discos maiores (pense em 20TB e superiores) oferecem melhor densidade e menor custo por terabyte. Por outro lado, as unidades mais pequenas (10-16TB) oferecem uma recuperação mais rápida, mais OSDs e melhor desempenho em certos cenários de falha.
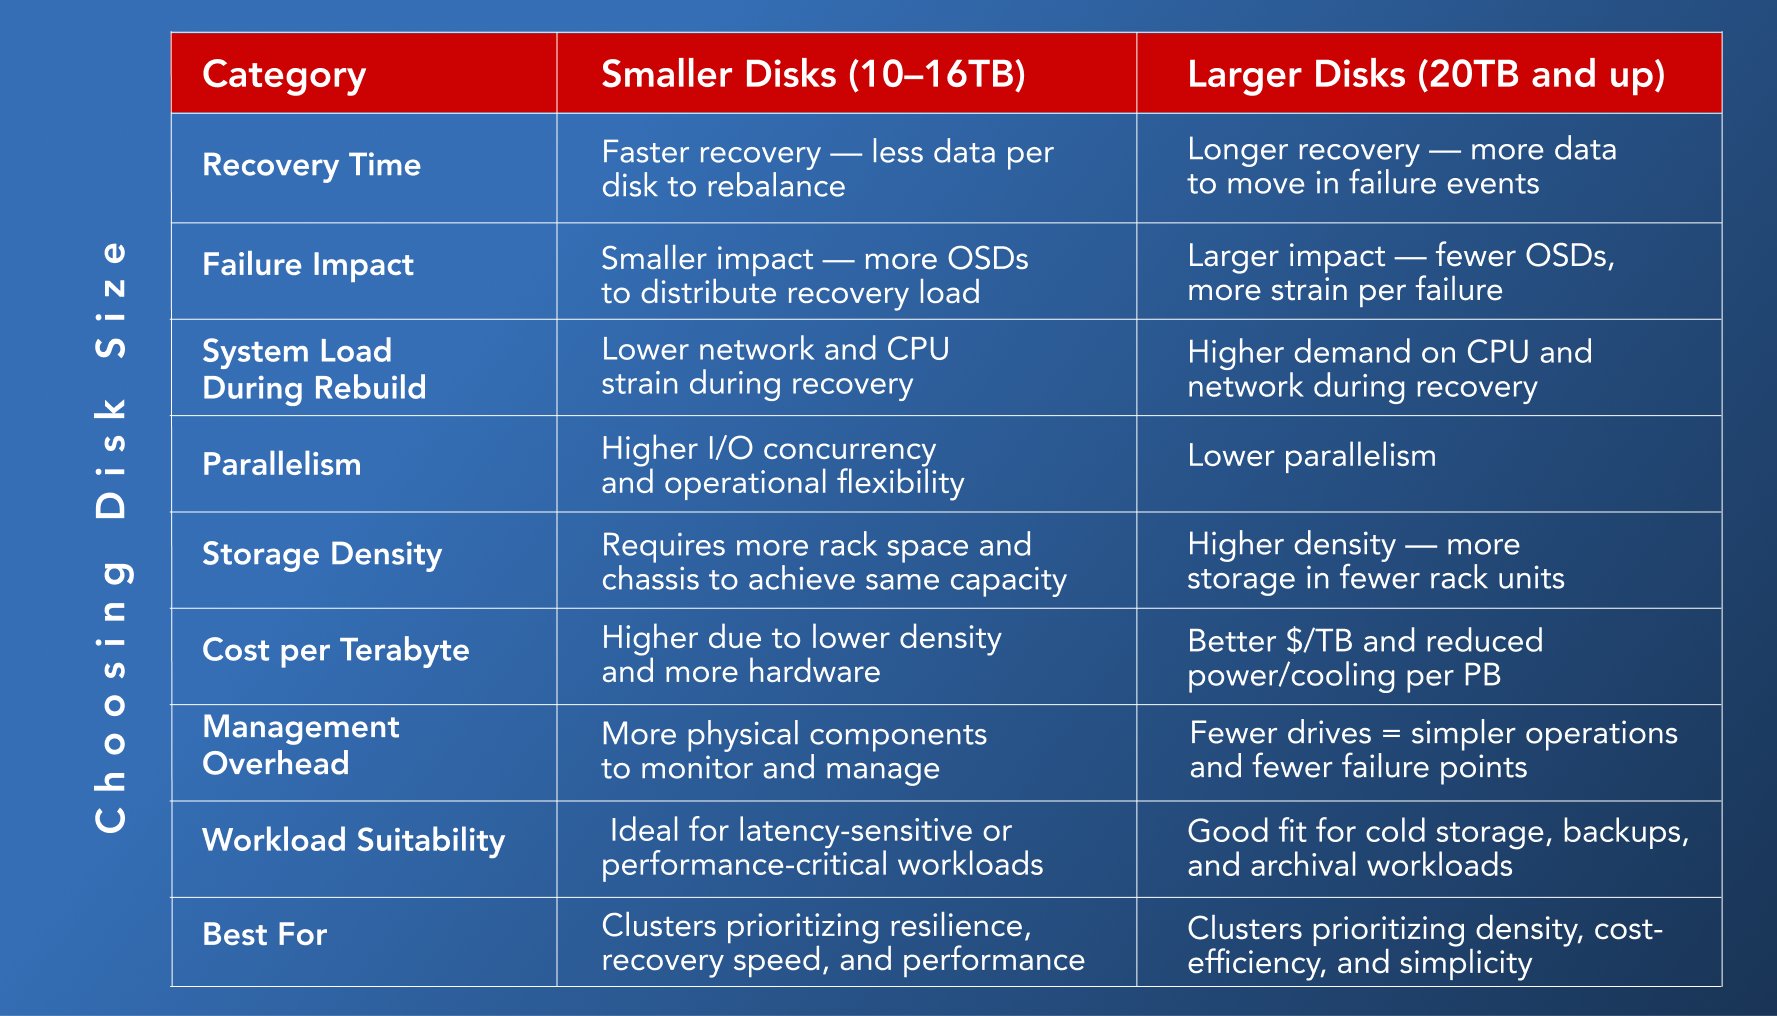
Discos Pequenos vs. Grandes no Ceph: Comparação e Casos de Uso
Os discos maiores vêm com atrasos na recuperação. Uma unidade de 20TB com falha pode levar horas, até dias para reequilibrar, especialmente numa rede saturada. E o impacto é maior: mais dados afetados, menos OSDs para distribuir a carga. Se as suas cargas de trabalho são sensíveis à latência — por exemplo, armazenamento de VM ou Kubernetes — os discos grandes podem tornar-se o seu gargalo de recuperação. Os discos mais pequenos, por outro lado, oferecem uma degradação graciosa e uma recuperação mais rápida.
Então, qual é a escolha certa? Se a resiliência e o desempenho são fundamentais, os discos mais pequenos ou de tamanho médio ganham. Recuperam mais rapidamente e escalam com menos dor. Se a sua prioridade máxima é a densidade e a eficiência da infraestrutura, e pode investir em redes rápidas (25-100GbE) e ampla capacidade de CPU, então os discos maiores são viáveis, desde que gerencie cuidadosamente os domínios de falha.
Tamanho do Disco no Ceph: Equilibrando Densidade, Custo e Considerações Operacionais
Ao projetar um cluster Ceph, uma das decisões-chave é escolher entre menos discos de alta capacidade ou mais discos de menor capacidade. Ambas as abordagens são viáveis, e cada uma traz as suas próprias vantagens dependendo dos seus objetivos de eficiência de custos, densidade e gestão operacional.
Um grande benefício dos discos maiores — como unidades de 20TB ou mesmo 24TB — é que oferecem um custo mais baixo por terabyte. Também facilitam a obtenção de alta densidade de armazenamento, especialmente em ambientes com restrições de rack. Isto pode ser particularmente atraente ao construir sistemas de armazenamento frio em grande escala ou ao planear o crescimento da capacidade a longo prazo.
No entanto, a densidade física também traz peso físico. Os HDDs normalmente pesam entre 0,5 a 0,75 kg cada. Num chassis de alta densidade 4U povoado com 90 unidades, o peso total pode exceder 100 kg por unidade. Um rack completo carregado com várias dessas unidades poderia aproximar-se ou ultrapassar 1.000 kg, o que está dentro das especificações do rack — mas nem todos os pisos de centros de dados estão classificados para suportar essa carga.
Ao planear implementações densas, é importante considerar não apenas a energia e o arrefecimento, mas também a capacidade de carga do piso, a integridade estrutural e as especificações do rack. Nestes ambientes, a densidade do disco não é apenas uma questão de capacidade ou custo — é uma questão de prontidão da infraestrutura.
No entanto, o tamanho do disco também influencia as operações diárias, especialmente ao planear processos de rotina como a limpeza ou lidar com falhas de hardware.
O mecanismo de limpeza do Ceph, que garante a integridade dos dados a longo prazo verificando a deterioração de bits ou corrupção silenciosa, torna-se mais intensivo em recursos com unidades maiores. Como é uma tarefa em segundo plano que usa CPU e memória, a duração do processo escala com a capacidade do disco.
Da mesma forma, no caso de uma falha de nó ou disco, a quantidade de dados que precisa de ser reequilibrada ou recuperada será naturalmente maior ao usar unidades maiores. Isto não representa um problema em si, mas é uma consideração operacional a ter em conta ao dimensionar recursos de computação, planear a taxa de transferência da rede ou estimar janelas de recuperação.
Para ilustrar:
- Um nó com 102 discos HDD de 10TB teria 1,02PB de capacidade bruta para reequilibrar num evento de falha.
- O mesmo nó com 102 discos de 20TB exigiria lidar com 2,04PB para reequilibrar num evento de falha.
Isto não significa que uma abordagem seja melhor que a outra — trata-se mais de alinhar as escolhas de hardware com as suas expectativas operacionais:
- Se priorizar o custo por PB e a eficiência do rack, os discos grandes são uma opção forte.
- Se reconstruções mais rápidas e menor impacto de recuperação por disco forem mais críticos, uma estratégia de disco menor pode ser mais adequada para si.
Em última análise, ambos os caminhos são válidos, e planear estas nuances desde o início leva a uma implementação Ceph mais resiliente e eficiente.
JBODs: Económicos, Escaláveis e Não Um Código de Trapaça
Na corrida para escalar o armazenamento sem estourar o orçamento, os JBODs — Just a Bunch of Disks — tornaram-se uma opção tentadora. E em muitos casos, com razão.
Um JBOD é um invólucro de disco preenchido com unidades individuais que não estão agrupadas numa matriz RAID. Em vez disso, são expostas ao sistema operativo host ou à camada de armazenamento definida por software (como Ceph, ZFS ou RAID de software) como dispositivos independentes. Isso significa que a redundância, a tolerância a falhas e a recuperação residem no software, não no hardware.
Nas implementações Ceph, os JBODs são tipicamente usados para estender a capacidade de armazenamento do servidor ao qual estão diretamente ligados — não como aparelhos autónomos. Este modelo alinha-se bem com a arquitetura do Ceph, onde o servidor fornece a lógica e o JBOD fornece a capacidade bruta do disco. Não se trata apenas de poupar custos — trata-se de expandir o armazenamento de forma eficiente e compacta, usando invólucros que podem alojar um grande número de unidades.
Para muitas equipas que constroem sistemas Ceph ou outros sistemas de armazenamento de objetos, os JBODs fazem sentido. Pode começar com um invólucro parcialmente preenchido e adicionar unidades conforme necessário. Não há necessidade de sobre-provisionar hardware antecipadamente. É um modelo que reduz o CapEx e atrasa o investimento total até que a procura de armazenamento o justifique.
Claro que, como com qualquer componente de infraestrutura, tirar o máximo proveito dos JBODs requer um planeamento cuidadoso. A redundância, fiabilidade e recuperabilidade devem ser incorporadas.
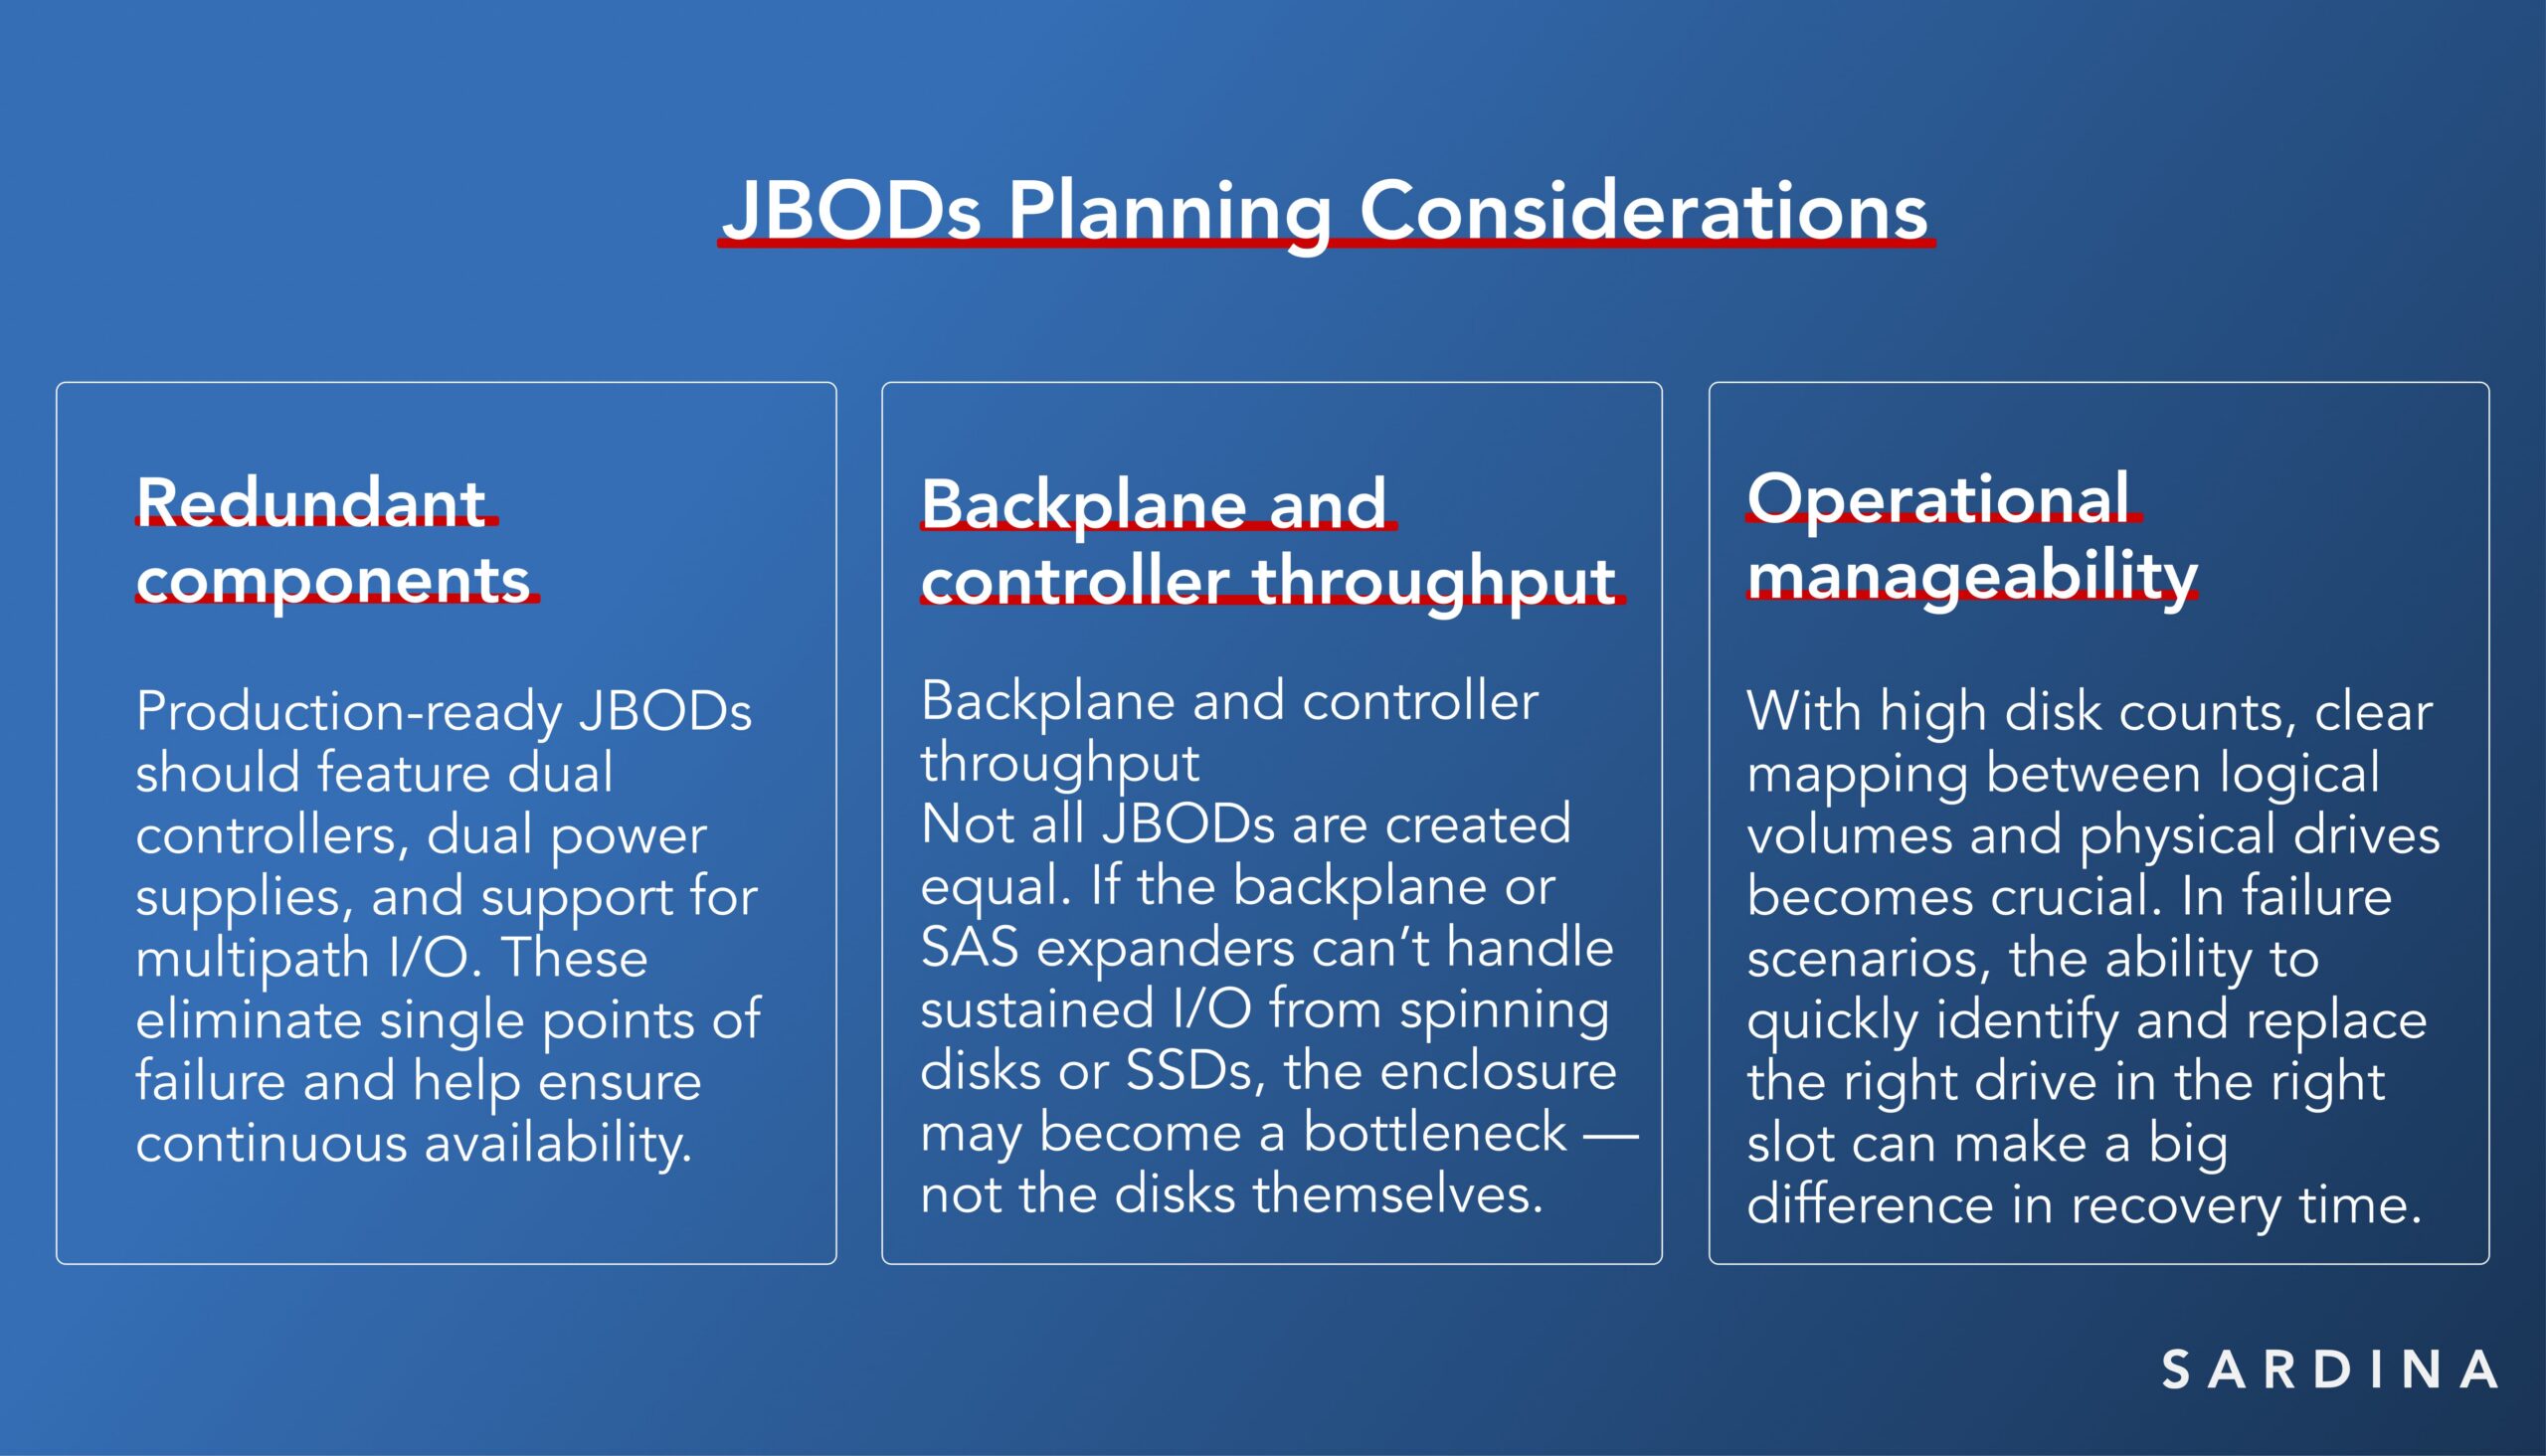
Quando devidamente integrados numa arquitetura baseada em Ceph, os JBODs oferecem um caminho elegante e eficiente para o armazenamento em grande escala, especialmente para cargas de trabalho como backup, arquivamento, bibliotecas de média e lagos de dados de investigação.
Em vez de os ver como um compromisso, é mais preciso ver os JBODs como uma ferramenta no kit do arquiteto. Com o design certo, os clusters baseados em JBOD podem oferecer desempenho, fiabilidade e eficiência de custos em escala.
Réplica vs Codificação de Eliminação: Fazendo uma Aposta Unidirecional
O Ceph dá-lhe escolhas, mas algumas dessas escolhas são portas unidirecionais. No centro deste compromisso está a escolha entre replicação e codificação de eliminação (EC) como política de armazenamento.
- Replica-3 armazena três cópias de cada bloco de dados em diferentes nós, oferecendo simplicidade e alto desempenho, especialmente para operações de E/S pequenas.
- A Codificação de Eliminação divide os dados em fragmentos de dados e paridade, permitindo a recuperação de quaisquer duas falhas enquanto usa menos capacidade geral. EC 3+2 é apenas uma das configurações de codificação de eliminação mais comuns que o Ceph suporta. Dependendo da sua tolerância ao risco, objetivos de desempenho e metas de capacidade utilizável, perfis alternativos como EC 4+2, 6+3 ou 8+4 podem oferecer um melhor alinhamento.
Mas eis o problema: uma vez que configure um pool de armazenamento com Replica-3, mudar para, por exemplo, EC 3+2 requer tempo de inatividade. A migração envolve um processo completo de descarga e carregamento, exportando todos os dados de um pool e reimportando-os para outro. Embora fornecedores de serviços como a Sardina Systems possam ajudar com a operação, a interrupção é inevitável.
Isto significa que o seu modelo de durabilidade de dados não é apenas uma escolha técnica — é um compromisso. Se planeia começar com Replica-3 e mais tarde mudar para EC para uma melhor eficiência de armazenamento, esteja preparado para uma janela de serviço planeada e os riscos associados.
Orçamento vs. Resiliência: O Ato de Equilíbrio da Infraestrutura
Todas estas decisões — estratégia de replicação, tamanho do disco, design do nó e escolha do invólucro — resumem-se a uma tensão central: equilibrar o orçamento hoje com a resiliência de amanhã. Os arquitetos de infraestrutura devem perguntar:
- Podemos permitir-nos tempo de inatividade mais tarde se cortarmos custos agora?
- O hardware que compramos hoje limitará as nossas escolhas daqui a 12 meses?
- Estamos a projetar para falhas ou apenas a esperar que não aconteçam?
Estas não são questões teóricas. Elas afetam diretamente os prazos de aquisição, o planeamento de capacidade e, em última análise, a experiência do utilizador.
Conclusões: o que todos os compradores de Ceph devem saber
Para muitas organizações, as conclusões são claras:
- Sim, pode começar com três nós, mas planeie cuidadosamente. Se prevê necessitar de EC no futuro, aceite que a migração requer tempo de inatividade e esforço operacional.
- Projete com cinco nós desde o início, se possível. Mesmo uma configuração modesta de EC 3+2 com 5 nós pode oferecer melhor eficiência de armazenamento e recuperação mais fácil sem aumentar significativamente a sua pegada em rack.
- Não pense apenas em capacidade — pense em falhas. Um cluster Ceph bem equilibrado otimiza CPU, RAM, tamanho do disco e domínio de falha.
O Ceph é incrivelmente flexível, mas flexibilidade não significa que possa ignorar o planeamento arquitetónico. As decisões tomadas no início podem fixar compromissos que são caros ou disruptivos de reverter mais tarde. Portanto, antes de instalar o primeiro nó, pergunte-se:
- Vou precisar de codificação de eliminação?
- Quanto tempo de inatividade posso tolerar durante a migração?
- Quão rápida quero que seja a recuperação?
- Quão densos quero que sejam os meus racks?
- Preciso de expandir gradualmente, e como?
As respostas podem mudar a forma como constrói o seu cluster e quão suavemente a sua infraestrutura escala.