
A medida que las organizaciones se inclinan cada vez más por la infraestructura definida por software, Ceph se ha convertido en una solución de referencia para construir sistemas de almacenamiento escalables y resistentes. Sin embargo, para muchos líderes de TI, la pregunta sigue siendo: ¿Se puede empezar poco a poco con Ceph y ampliarlo más adelante sin toparse con obstáculos arquitectónicos u operativos?
Esto es más que una consideración teórica. En los entornos de TI actuales, donde se cuida el presupuesto, las empresas suelen implementar sistemas de almacenamiento por fases. Sin embargo, las primeras decisiones (tamaño del disco, perfil de almacenamiento y densidad de nodos) a menudo crean cuellos de botella arquitectónicos que son dolorosos y costosos de deshacer.
Para muchas organizaciones, empezar poco a poco con Ceph es una opción práctica y rentable. Un clúster de 3 nodos ofrece una base sólida y cumple con el requisito mínimo para ejecutar un sistema totalmente funcional y redundante utilizando el modelo Réplica-3, que almacena tres copias de cada objeto en los nodos.
Pero aunque esta configuración funciona bien a corto plazo, conlleva contrapartidas a largo plazo que pueden complicar el crecimiento futuro. A medida que las infraestructuras se expanden, el reto de mantener el rendimiento, la resistencia y la simplicidad operativa crece significativamente.
En este artículo, exploraremos las consideraciones clave que los arquitectos de sistemas deben tener en cuenta al planificar el escalado de clústeres de Ceph: desde el número de nodos y la codificación de borrado hasta la densidad del hardware y las estrategias de recuperación de datos.
Entonces, ¿se puede empezar poco a poco con Ceph?
Una de las preguntas más comunes de los equipos de infraestructura es si pueden empezar con un clúster mínimo, como tres nodos, y escalarlo más adelante. La respuesta corta es sí, pero solo si está dispuesto a pensar como si fuera a escalar desde el primer día.
La diferencia entre estas dos opciones revela una idea clave: los discos más grandes no solo significan más capacidad, sino también tiempos de recuperación más largos en caso de fallo. El tamaño del disco es donde las cosas se ponen interesantes y divisivas.
Por un lado, los discos más grandes (de 20 TB en adelante) ofrecen una mejor densidad y un menor coste por terabyte. Por otro lado, las unidades más pequeñas (de 10 a 16 TB) ofrecen una recuperación más rápida, más OSD y un mejor rendimiento en determinados escenarios de fallo.
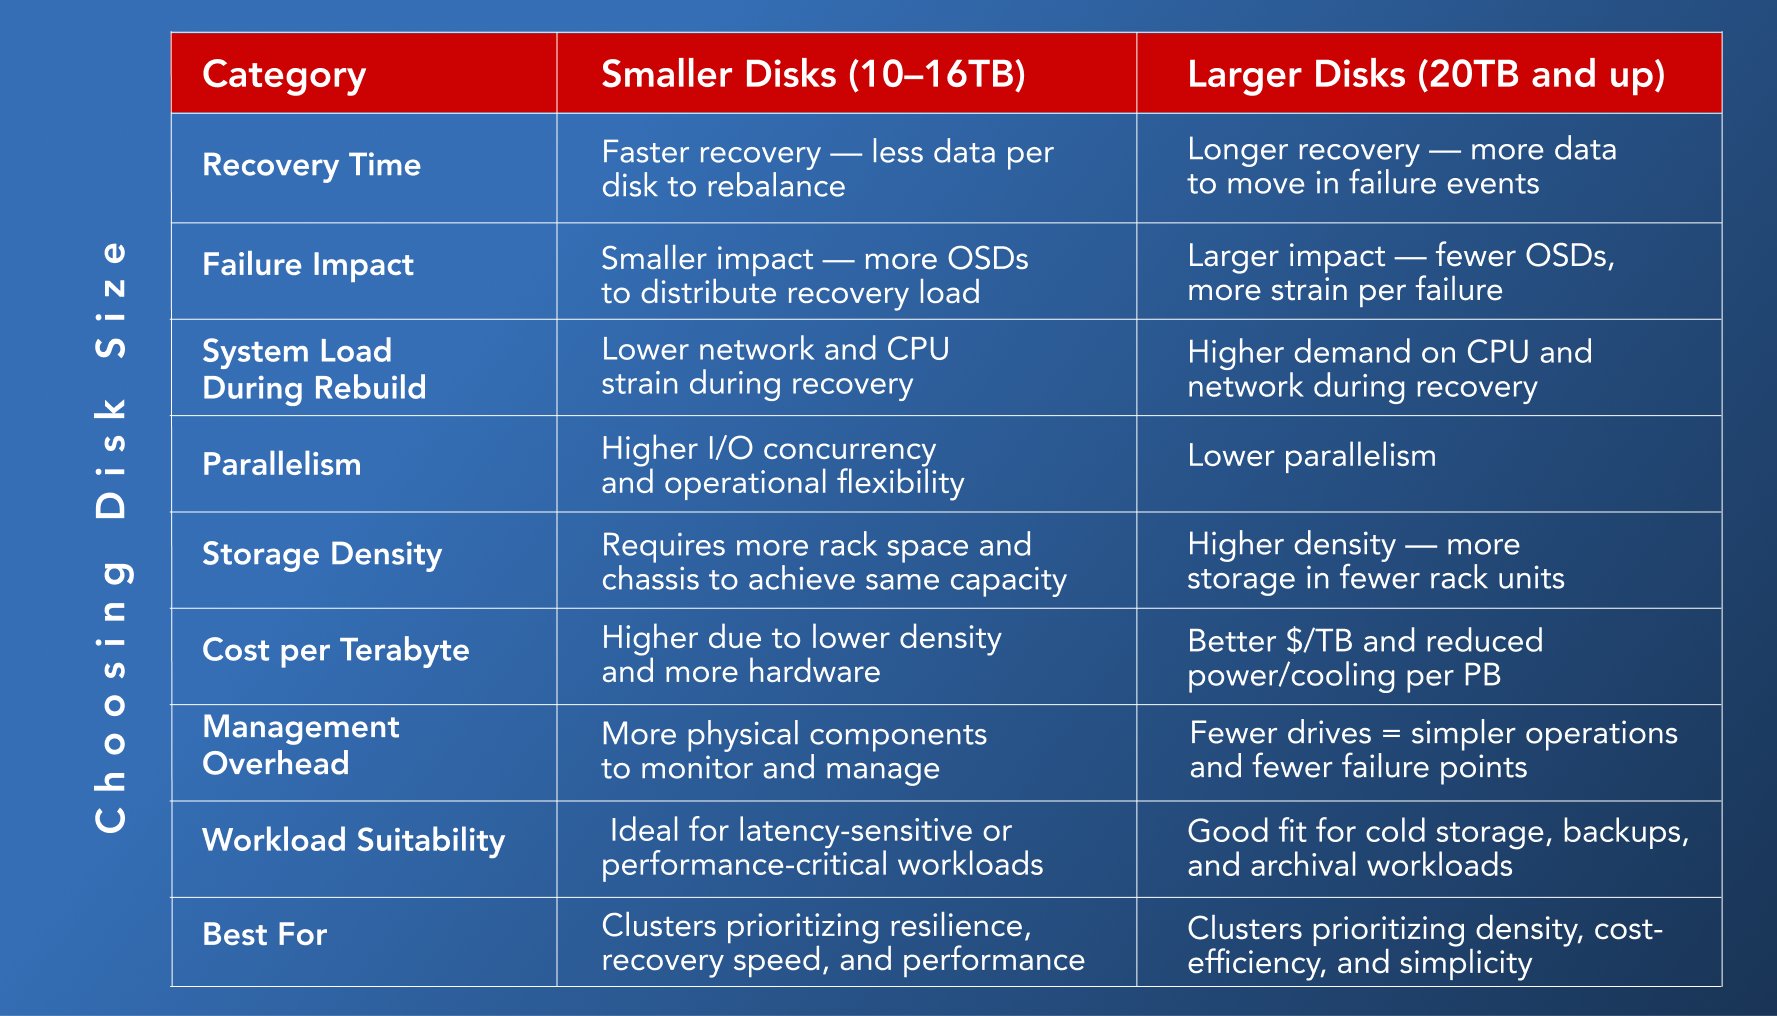
Discos pequeños vs. grandes en Ceph: comparación y casos de uso
Los discos más grandes conllevan retrasos en la recuperación. Una unidad de 20 TB que falla puede tardar horas, incluso días, en reequilibrarse, especialmente en una red saturada. Y el impacto es mayor: más datos afectados, menos OSD para repartir la carga. Si sus cargas de trabajo son sensibles a la latencia (por ejemplo, almacenamiento de VM o Kubernetes), los discos grandes pueden convertirse en su cuello de botella de recuperación. Los discos más pequeños, por otro lado, ofrecen una degradación elegante y una recuperación más rápida.
¿Cuál es entonces la elección correcta? Si la resistencia y el rendimiento son clave, los discos pequeños o medianos ganan. Se recuperan más rápido y escalan con menos problemas. Si su máxima prioridad es la densidad y la eficiencia de la infraestructura, y puede invertir en redes rápidas (25–100 GbE) y amplia sobrecarga de CPU, entonces los discos más grandes son viables, siempre que gestione cuidadosamente los dominios de fallo.
Tamaño del disco en Ceph: equilibrio entre densidad, coste y consideraciones operativas
Al diseñar un clúster de Ceph, una de las decisiones clave es elegir entre menos discos de alta capacidad o más discos de menor capacidad. Ambos enfoques son viables, y cada uno aporta sus propias ventajas en función de sus objetivos de rentabilidad, densidad y facilidad de gestión operativa.
Una de las principales ventajas de los discos más grandes, como las unidades de 20 TB o incluso de 24 TB, es que ofrecen un menor coste por terabyte. También facilitan la consecución de una alta densidad de almacenamiento, especialmente en entornos con limitaciones de espacio en el rack. Esto puede ser particularmente atractivo cuando se construyen sistemas de almacenamiento en frío a gran escala o cuando se planifica el crecimiento de la capacidad a largo plazo.
Sin embargo, la densidad física también aporta peso físico. Los HDD suelen pesar entre 0,5 y 0,75 kg cada uno. En un chasis 4U de alta densidad con 90 unidades, el peso total puede superar los 100 kg por unidad. Un rack completo cargado con varias unidades de este tipo podría acercarse o superar los 1.000 kg, lo que está dentro de las especificaciones del rack, pero no todos los suelos de los centros de datos están preparados para soportar esa carga.
Al planificar implementaciones densas, es importante tener en cuenta no solo la alimentación y la refrigeración, sino también la capacidad de carga del suelo, la integridad estructural y las especificaciones del rack. En estos entornos, la densidad de los discos no es solo una cuestión de capacidad o coste, sino una cuestión de preparación de la infraestructura.
Sin embargo, el tamaño del disco también influye en las operaciones diarias, especialmente al planificar procesos rutinarios como el scrubbing o la gestión de fallos de hardware.
El mecanismo de scrubbing de Ceph, que garantiza la integridad de los datos a largo plazo comprobando la degradación de bits o la corrupción silenciosa, se vuelve más intensivo en recursos con unidades más grandes. Dado que es una tarea en segundo plano que utiliza CPU y memoria, la duración del proceso se escala con la capacidad del disco.
Del mismo modo, en caso de fallo de un nodo o de un disco, la cantidad de datos que deben reequilibrarse o recuperarse será naturalmente mayor cuando se utilicen unidades más grandes. Esto no supone un problema en sí mismo, pero es una consideración operativa a tener en cuenta al dimensionar los recursos informáticos, planificar el rendimiento de la red o estimar los plazos de recuperación.
Para ilustrar:
- Un nodo con 102 discos HDD de 10 TB tendría 1,02 PB de capacidad bruta para reequilibrar en caso de fallo.
- El mismo nodo con 102 discos de 20 TB requeriría gestionar 2,04 PB para reequilibrar en caso de fallo.
Esto no significa que un enfoque sea mejor que el otro, sino que se trata de alinear las opciones de hardware con sus expectativas operativas:
- Si prioriza el coste por PB y la eficiencia del rack, los discos grandes son una opción sólida.
- Si las reconstrucciones más rápidas y el menor impacto de la recuperación por disco son más críticos, una estrategia de disco más pequeño podría ser más adecuada para usted.
En última instancia, ambos caminos son válidos, y la planificación de estos matices desde el principio conduce a una implementación de Ceph más resistente y eficiente.
JBOD: rentables, escalables y no un código de trucos
En la carrera por escalar el almacenamiento sin disparar el presupuesto, los JBOD — Just a Bunch of Disks (solo un montón de discos)— se han convertido en una opción tentadora. Y en muchos casos, con razón.
Un JBOD es una carcasa de disco llena de unidades individuales que no están agrupadas en una matriz RAID. En cambio, se exponen al sistema operativo host o a la capa de almacenamiento definida por software (como Ceph, ZFS o RAID por software) como dispositivos independientes. Esto significa que la redundancia, la tolerancia a fallos y la recuperación residen en el software, no en el hardware.
En las implementaciones de Ceph, los JBOD se utilizan normalmente para ampliar la capacidad de almacenamiento del servidor al que están conectados directamente, no como dispositivos independientes. Este modelo se alinea bien con la arquitectura de Ceph, donde el servidor proporciona la lógica y el JBOD proporciona la capacidad de disco bruta. No se trata solo de ahorrar costes, sino de ampliar el almacenamiento de forma eficiente y compacta, utilizando carcasas que pueden albergar un gran número de unidades.
Para muchos equipos que construyen Ceph u otros sistemas de almacenamiento de objetos, los JBOD tienen sentido. Puede empezar con una carcasa parcialmente llena y añadir unidades según sea necesario. No es necesario aprovisionar en exceso el hardware por adelantado. Es un modelo que reduce los gastos de capital y retrasa la inversión total hasta que la demanda de almacenamiento lo justifique.
Por supuesto, como con cualquier componente de la infraestructura, sacar el máximo partido de los JBOD requiere una planificación cuidadosa. La redundancia, la fiabilidad y la capacidad de recuperación deben estar integradas.
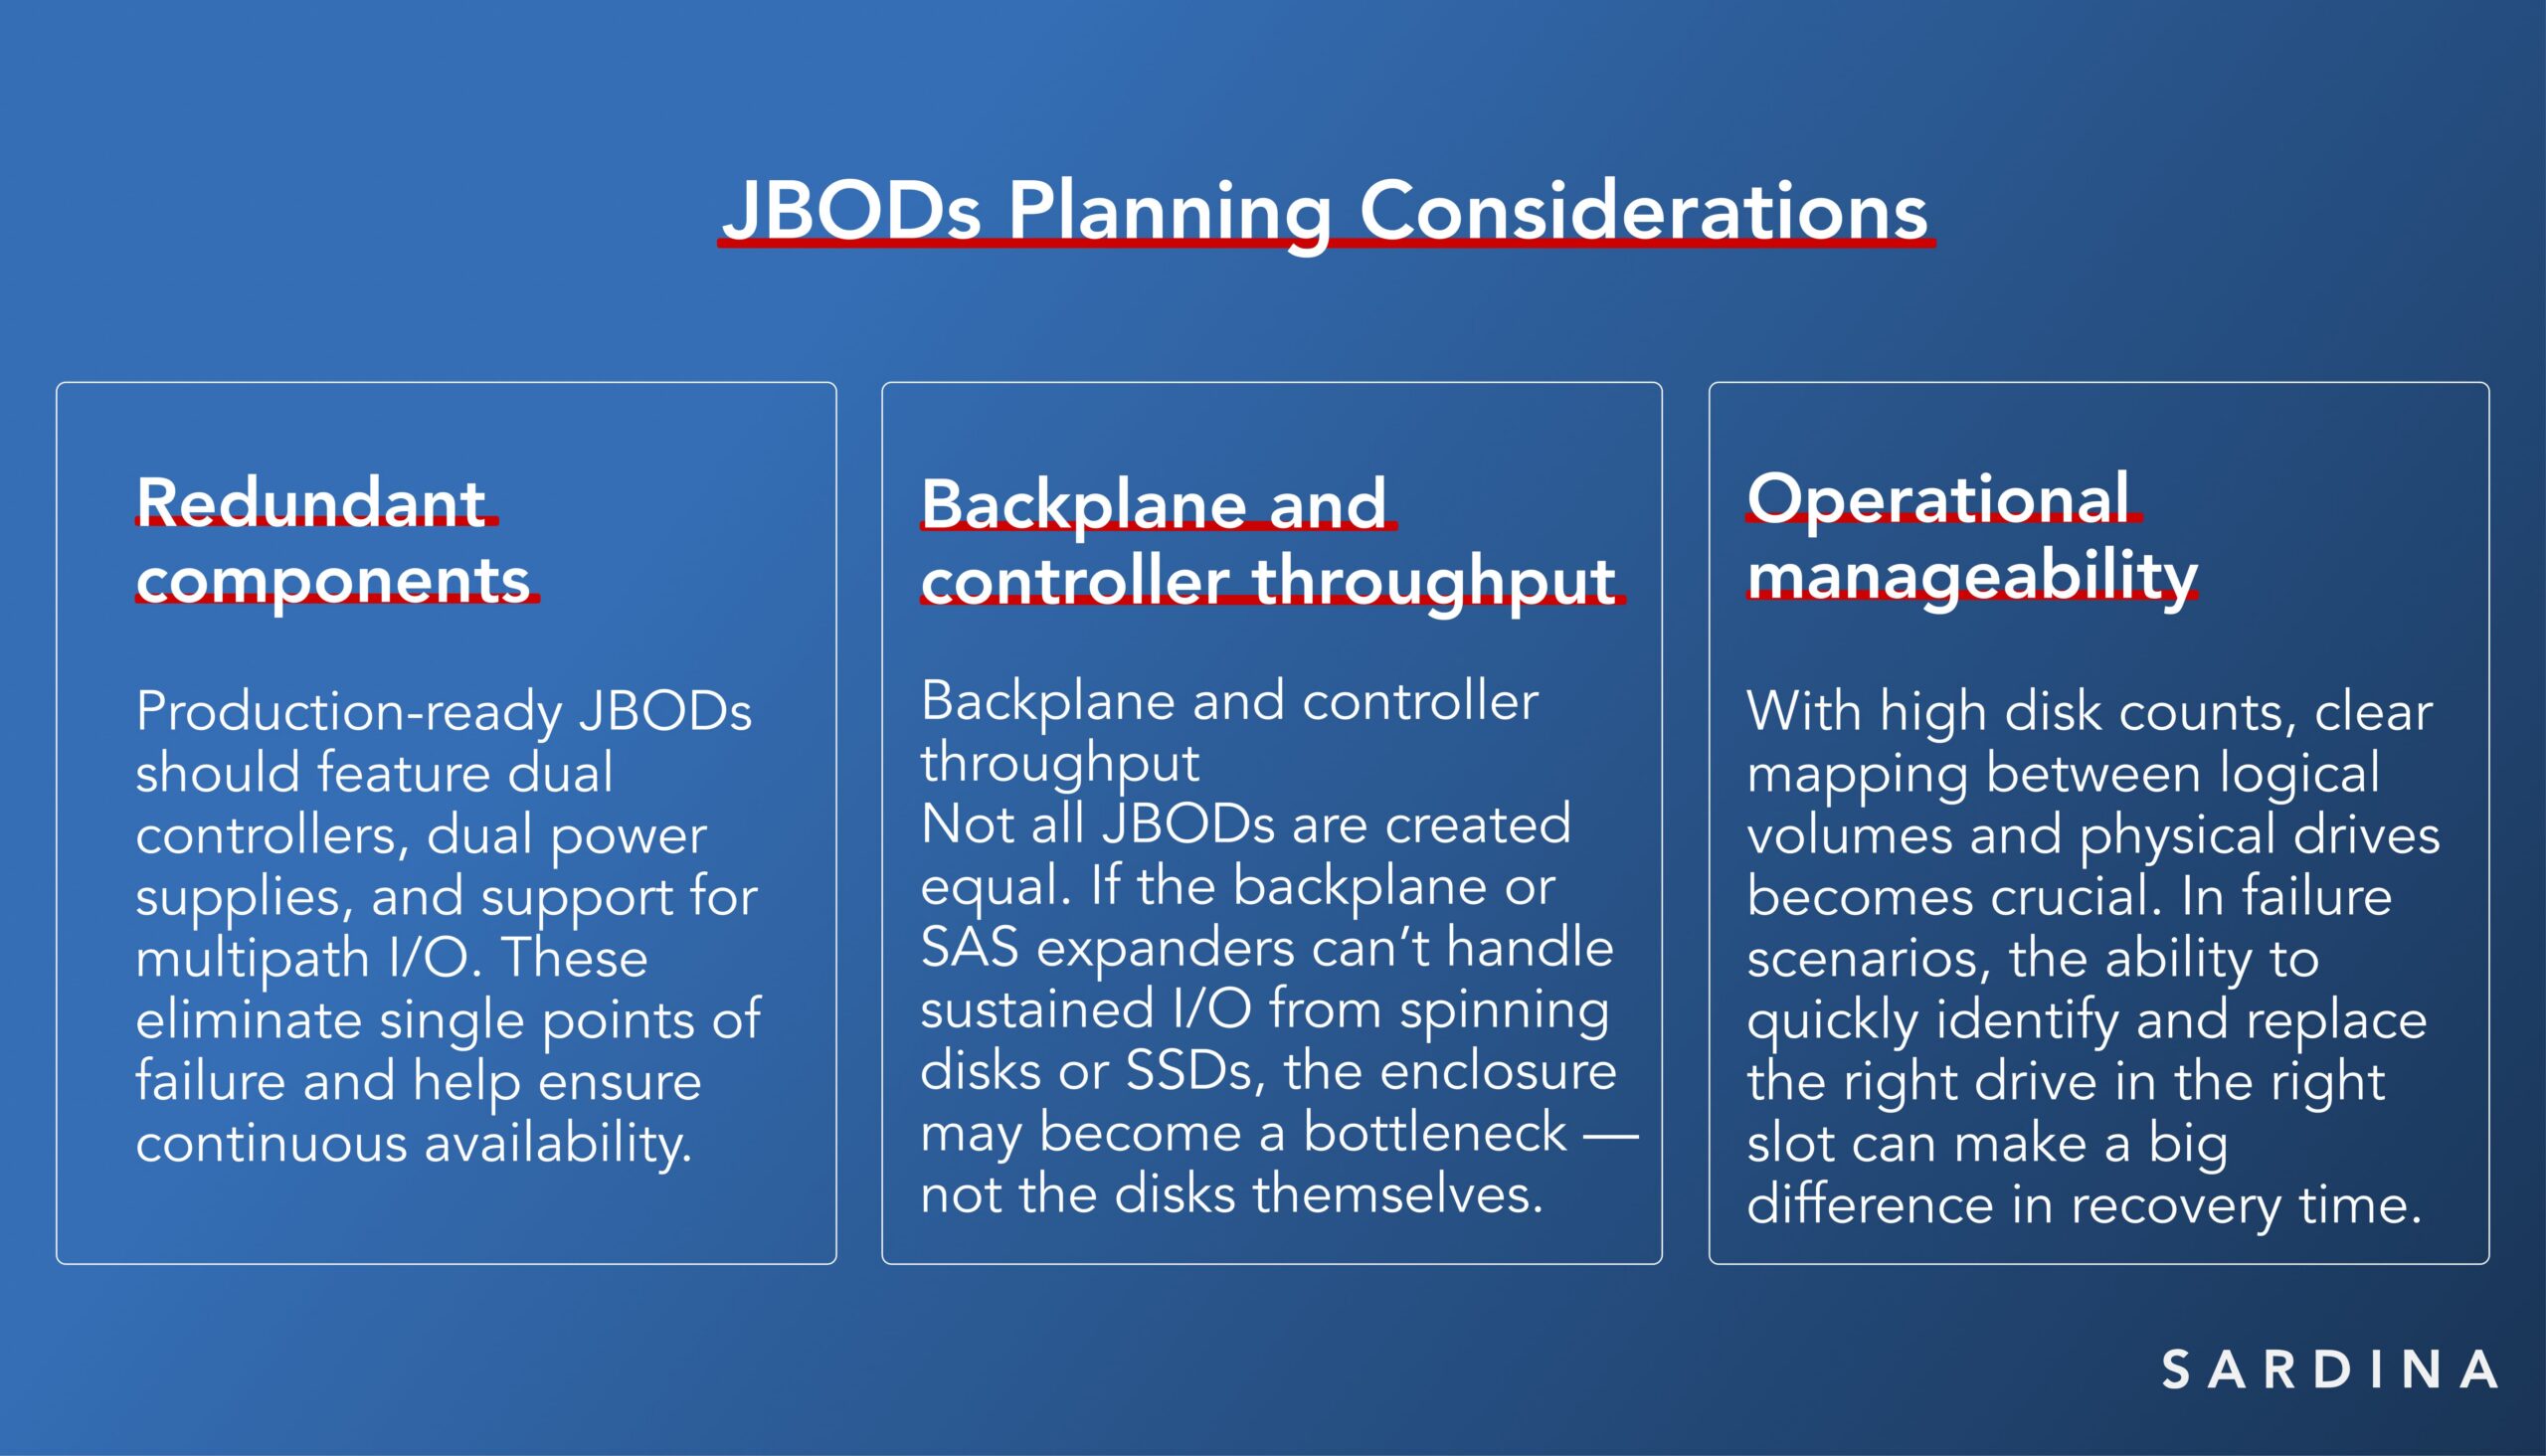
Cuando se integran correctamente en una arquitectura basada en Ceph, los JBOD ofrecen una vía elegante y eficiente hacia el almacenamiento a gran escala, especialmente para cargas de trabajo como copias de seguridad, archivos, bibliotecas multimedia y lagos de datos de investigación.
En lugar de verlos como un compromiso, es más preciso ver los JBOD como una herramienta en el kit del arquitecto. Con el diseño adecuado, los clústeres basados en JBOD pueden ofrecer rendimiento, fiabilidad y rentabilidad a escala.
Réplica vs. codificación de borrado: hacer una apuesta unidireccional
Ceph le da opciones, pero algunas de esas opciones son puertas de un solo sentido. En el centro de esta compensación se encuentra la elección entre replicación y codificación de borrado (EC) como política de almacenamiento.
- Réplica-3 almacena tres copias de cada bloque de datos en diferentes nodos, ofreciendo simplicidad y alto rendimiento, especialmente para pequeñas operaciones de E/S.
- La codificación de borrado divide los datos en fragmentos de datos y paridad, lo que permite la recuperación de cualquier fallo mientras se utiliza menos capacidad total. EC 3+2 es solo una de las configuraciones de codificación de borrado más comunes que admite Ceph. Dependiendo de su tolerancia al riesgo, sus objetivos de rendimiento y sus objetivos de capacidad utilizable, los perfiles alternativos como EC 4+2, 6+3 u 8+4 pueden ofrecer una mejor alineación.
Pero aquí está la trampa: una vez que se configura un grupo de almacenamiento con Réplica-3, cambiar a, por ejemplo, EC 3+2 requiere tiempo de inactividad. La migración implica un proceso completo de volcado y carga, exportando todos los datos de un grupo y reimportándolos en otro. Aunque los proveedores de servicios como Sardina Systems pueden ayudar con la operación, la interrupción es inevitable.
Esto significa que su modelo de durabilidad de los datos no es solo una elección técnica, sino un compromiso. Si planea empezar con Réplica-3 y luego cambiar a EC para una mejor eficiencia de almacenamiento, prepárese para una ventana de servicio planificada y los riesgos asociados.
Presupuesto vs. Resiliencia: El acto de equilibrio de la infraestructura
Todas estas decisiones (estrategia de replicación, tamaño del disco, diseño del nodo y elección de la carcasa) se reducen a una tensión central: equilibrar el presupuesto de hoy con la resiliencia de mañana. Los arquitectos de la infraestructura deben preguntarse:
- ¿Podemos permitirnos un tiempo de inactividad más adelante si recortamos gastos ahora?
- ¿Limitará el hardware que compremos hoy nuestras opciones en 12 meses?
- ¿Estamos diseñando para el fallo o simplemente esperando que no ocurra?
Estas no son preguntas teóricas. Impactan directamente en los plazos de adquisición, la planificación de la capacidad y, en última instancia, la experiencia del usuario.
Conclusiones: lo que todo comprador de Ceph debe saber
Para muchas organizaciones, las conclusiones son claras:
- Sí, puede empezar con tres nodos, pero planifique cuidadosamente. Si prevé la necesidad de EC en el futuro, acepte que la migración requiere tiempo de inactividad y esfuerzo operativo.
- Diseñe con cinco nodos desde el principio, si es posible. Incluso una configuración modesta de 5 nodos EC 3+2 puede ofrecer una mejor eficiencia de almacenamiento y una recuperación más fácil sin aumentar significativamente su huella de rack.
- No piense solo en la capacidad, piense en el fallo. Un clúster de Ceph bien equilibrado se optimiza para la CPU, la RAM, el tamaño del disco y el dominio de fallo.
Ceph es increíblemente flexible, pero la flexibilidad no significa que pueda saltarse la planificación arquitectónica. Sus decisiones tomadas al principio pueden bloquear compensaciones que son costosas o perjudiciales para revertir más tarde. Así que antes de montar ese primer nodo, pregúntese:
- ¿Necesitaré la codificación de borrado?
- ¿Cuánto tiempo de inactividad puedo tolerar durante la migración?
- ¿Qué tan rápido quiero que sea la recuperación?
- ¿Qué tan densos quiero que sean mis racks?
- ¿Necesito expandirme gradualmente, y cómo?
Las respuestas pueden cambiar la forma en que construye su clúster y la fluidez con la que se escala su infraestructura.