
Alors que les organisations s’orientent de plus en plus vers une infrastructure définie par logiciel, Ceph s’est imposé comme une solution de choix pour construire des systèmes de stockage évolutifs et résilients. Pourtant, pour de nombreux responsables informatiques, la question demeure : peut-on commencer petit avec Ceph et s’étendre plus tard sans rencontrer d’obstacles architecturaux ou opérationnels ?
Il ne s’agit pas simplement d’une considération théorique. Dans les environnements informatiques actuels soucieux des budgets, les entreprises déploient souvent des systèmes de stockage par phases. Cependant, les premiers choix — taille des disques, profil de stockage et densité des nœuds — créent souvent des goulots d’étranglement architecturaux qui sont pénibles et coûteux à défaire.
Pour de nombreuses organisations, commencer petit avec Ceph est un choix pratique et rentable. Un cluster à 3 nœuds offre une base solide et répond aux exigences minimales pour exécuter un système entièrement fonctionnel et redondant utilisant le modèle Replica-3, qui stocke trois copies de chaque objet à travers les nœuds.
Mais si cette configuration fonctionne bien à court terme, elle s’accompagne de compromis à long terme qui peuvent compliquer la croissance future. À mesure que les infrastructures se développent, le défi de maintenir les performances, la résilience et la simplicité opérationnelle augmente considérablement.
Dans cet article, nous explorerons les considérations clés dont les architectes système doivent tenir compte lors de la planification de la mise à l’échelle des clusters Ceph : du nombre de nœuds et du codage d’effacement à la densité matérielle et aux stratégies de récupération des données.
Alors, peut-on commencer petit avec Ceph ?
L’une des questions les plus fréquentes des équipes d’infrastructure est de savoir si elles peuvent commencer avec un cluster minimal, comme trois nœuds, et s’étendre plus tard. La réponse courte est oui, mais seulement si vous êtes prêt à penser comme une mise à l’échelle dès le premier jour.
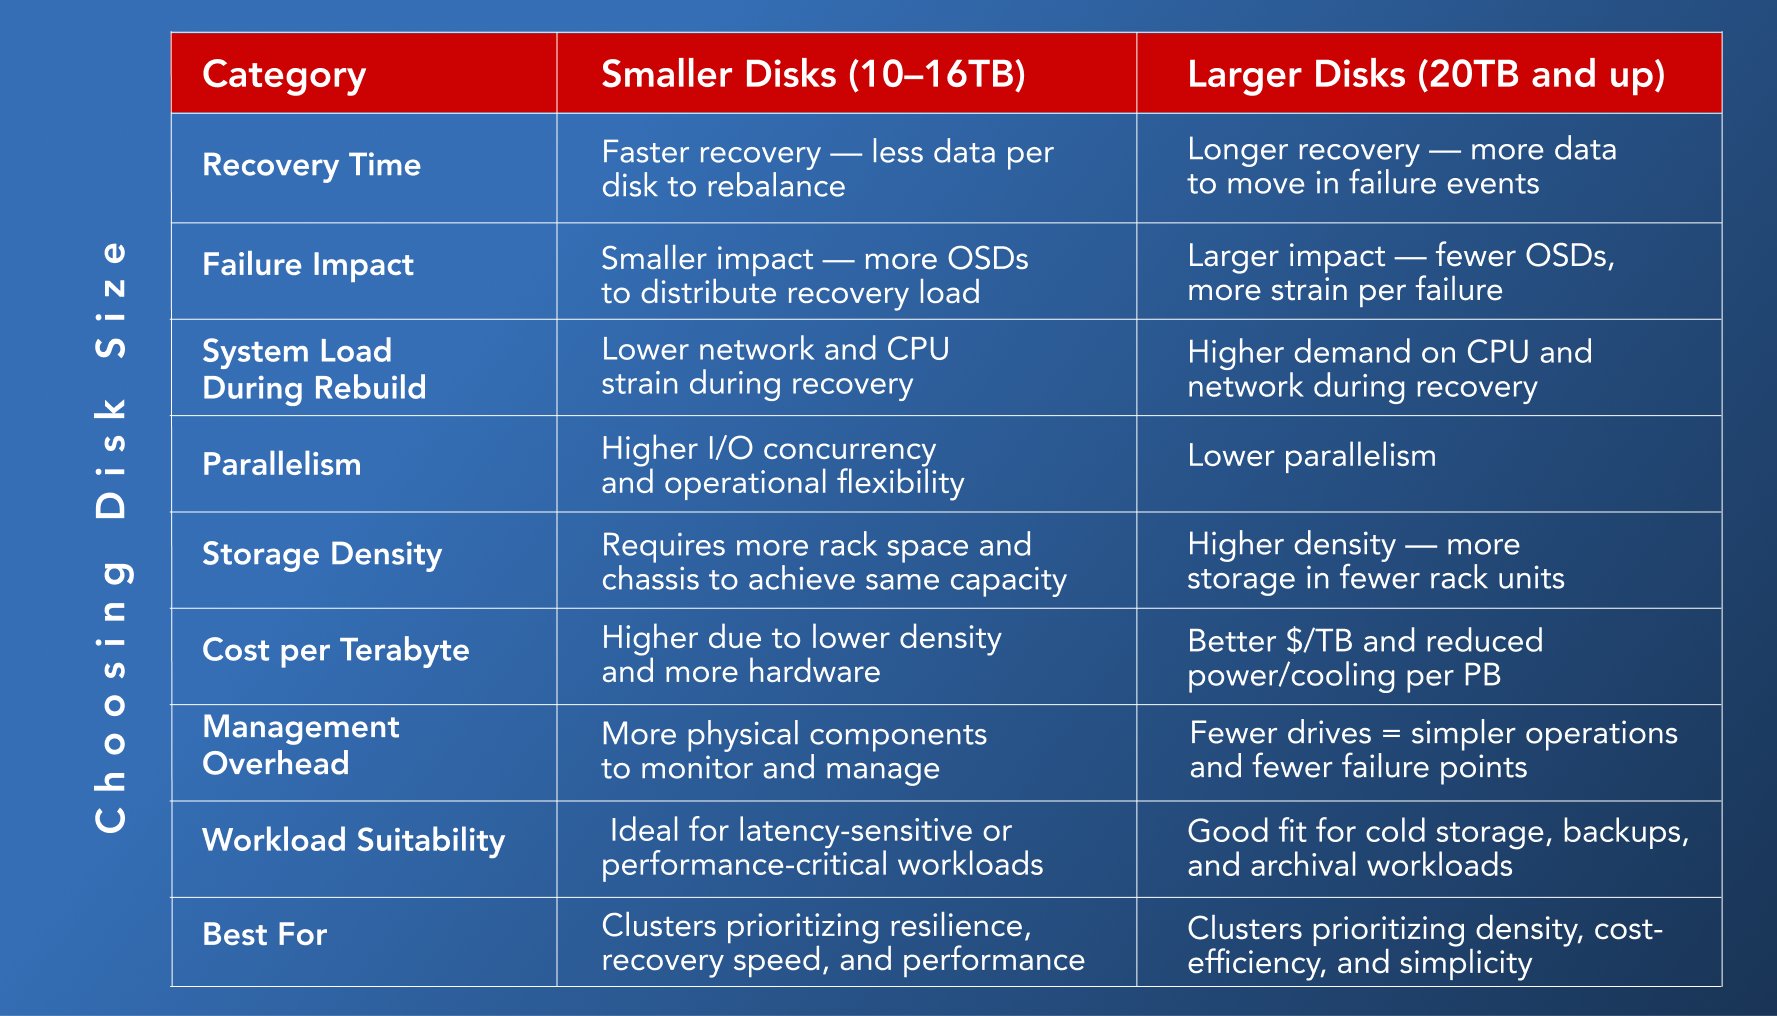
La différence entre ces deux options révèle une perspective clé : des disques plus grands ne signifient pas seulement plus de capacité, ils impliquent aussi des temps de récupération plus longs en cas de panne.
D’un côté, les disques plus grands (20 To et plus) offrent une meilleure densité et un coût par téraoctet plus faible. De l’autre, les disques plus petits (10-16 To) offrent une récupération plus rapide, plus d’OSD et de meilleures performances dans certains scénarios de panne.
Petits vs grands disques dans Ceph : comparaison et cas d’utilisation
Les disques plus grands entraînent des délais de récupération. Un disque de 20 To en panne peut prendre des heures, voire des jours pour se rééquilibrer, particulièrement sur un réseau saturé. Et l’impact est plus important : plus de données affectées, moins d’OSD pour répartir la charge. Si vos charges de travail sont sensibles à la latence — par exemple, le stockage VM ou Kubernetes — les grands disques peuvent devenir votre goulot d’étranglement de récupération. Les disques plus petits, en revanche, offrent une dégradation gracieuse et un retour à la normale plus rapide.
Alors, quel est le bon choix ? Si la résilience et la performance sont essentielles, les disques plus petits ou de taille moyenne l’emportent. Ils récupèrent plus rapidement et s’adaptent avec moins de difficultés. Si votre priorité absolue est la densité et l’efficacité de l’infrastructure, et que vous pouvez investir dans des réseaux rapides (25-100 GbE) et une capacité CPU suffisante, alors les disques plus grands sont viables, à condition de gérer soigneusement les domaines de défaillance.
Taille des disques dans Ceph : équilibrer densité, coût et considérations opérationnelles
Lors de la conception d’un cluster Ceph, l’une des décisions clés est de choisir entre moins de disques à haute capacité ou plus de disques à capacité inférieure. Les deux approches sont viables, et chacune apporte ses propres avantages selon vos objectifs d’efficacité des coûts, de densité et de gestion opérationnelle.
Un avantage majeur des disques plus grands — comme les disques de 20 To ou même 24 To — est qu’ils offrent un coût par téraoctet plus faible. Ils facilitent également l’obtention d’une haute densité de stockage, particulièrement dans les environnements contraints en racks. Cela peut être particulièrement attrayant lors de la construction de systèmes de stockage froid à grande échelle ou lors de la planification de la croissance de la capacité à long terme.
Cependant, la densité physique apporte aussi un poids physique. Les disques durs pèsent généralement entre 0,5 et 0,75 kg chacun. Dans un châssis 4U haute densité peuplé de 90 disques, le poids total peut dépasser 100 kg par unité. Un rack complet chargé de plusieurs unités de ce type pourrait approcher ou dépasser 1 000 kg, ce qui est dans les spécifications du rack — mais tous les sols de centres de données ne sont pas conçus pour supporter cette charge.
Lors de la planification de déploiements denses, il est important de considérer non seulement l’alimentation et le refroidissement, mais aussi la capacité de charge au sol, l’intégrité structurelle et les spécifications des racks. Dans ces environnements, la densité des disques n’est pas seulement une question de capacité ou de coût — c’est une question de préparation de l’infrastructure.
Cependant, la taille des disques influence également les opérations quotidiennes, particulièrement lors de la planification des processus de routine comme le scrubbing ou la gestion des pannes matérielles.
Le mécanisme de scrubbing de Ceph, qui assure l’intégrité des données à long terme en vérifiant la corruption silencieuse ou la détérioration des bits, devient plus gourmand en ressources avec des disques plus grands. Comme c’est une tâche d’arrière-plan qui utilise le CPU et la mémoire, la durée du processus augmente avec la capacité du disque.
De même, en cas de panne d’un nœud ou d’un disque, la quantité de données à rééquilibrer ou à récupérer sera naturellement plus élevée lors de l’utilisation de disques plus grands. Cela ne pose pas de problème en soi, mais c’est une considération opérationnelle à prendre en compte lors du dimensionnement des ressources de calcul, de la planification du débit réseau ou de l’estimation des fenêtres de récupération.
Pour illustrer :
- Un nœud avec 102 disques HDD de 10 To aurait 1,02 Po de capacité brute à rééquilibrer en cas de panne.
- Le même nœud avec 102 disques de 20 To nécessiterait de gérer 2,04 Po à rééquilibrer en cas de panne.
Cela ne signifie pas qu’une approche est meilleure que l’autre — il s’agit plutôt d’aligner les choix matériels avec vos attentes opérationnelles :
- Si vous privilégiez le coût par Po et l’efficacité du rack, les grands disques sont une option solide.
- Si des reconstructions plus rapides et un impact de récupération plus faible par disque sont plus critiques, une stratégie de disques plus petits pourrait mieux vous convenir.
En fin de compte, les deux voies sont valables, et la planification de ces nuances dès le début conduit à un déploiement Ceph plus résilient et efficace.
JBODs : rentables, évolutifs, et pas une solution miracle
Dans la course à l’échelle du stockage sans faire exploser le budget, les JBODs — Just a Bunch of Disks — sont devenus une option tentante. Et dans de nombreux cas, à juste titre.
Un JBOD est un boîtier de disques rempli de lecteurs individuels qui ne sont pas regroupés en matrice RAID. Au lieu de cela, ils sont exposés au système d’exploitation hôte ou à la couche de stockage définie par logiciel (comme Ceph, ZFS ou RAID logiciel) en tant que périphériques indépendants. Cela signifie que la redondance, la tolérance aux pannes et la récupération résident dans le logiciel, pas dans le matériel.
Dans les déploiements Ceph, les JBODs sont généralement utilisés pour étendre la capacité de stockage du serveur auquel ils sont directement connectés — pas comme des appareils autonomes. Ce modèle s’aligne bien avec l’architecture de Ceph, où le serveur fournit la logique et le JBOD fournit la capacité brute des disques. Il ne s’agit pas seulement d’économiser des coûts — il s’agit d’étendre le stockage efficacement et de manière compacte, en utilisant des boîtiers pouvant héberger un grand nombre de disques.
Pour de nombreuses équipes construisant des systèmes Ceph ou d’autres systèmes de stockage d’objets, les JBODs ont du sens. Vous pouvez commencer avec un boîtier partiellement rempli et ajouter des disques selon les besoins. Pas besoin de sur-provisionner le matériel dès le départ. C’est un modèle qui réduit les dépenses d’investissement et retarde l’investissement complet jusqu’à ce que la demande de stockage le justifie.
Bien sûr, comme pour tout composant d’infrastructure, tirer le meilleur parti des JBODs nécessite une planification réfléchie. La redondance, la fiabilité et la récupérabilité doivent être intégrées.
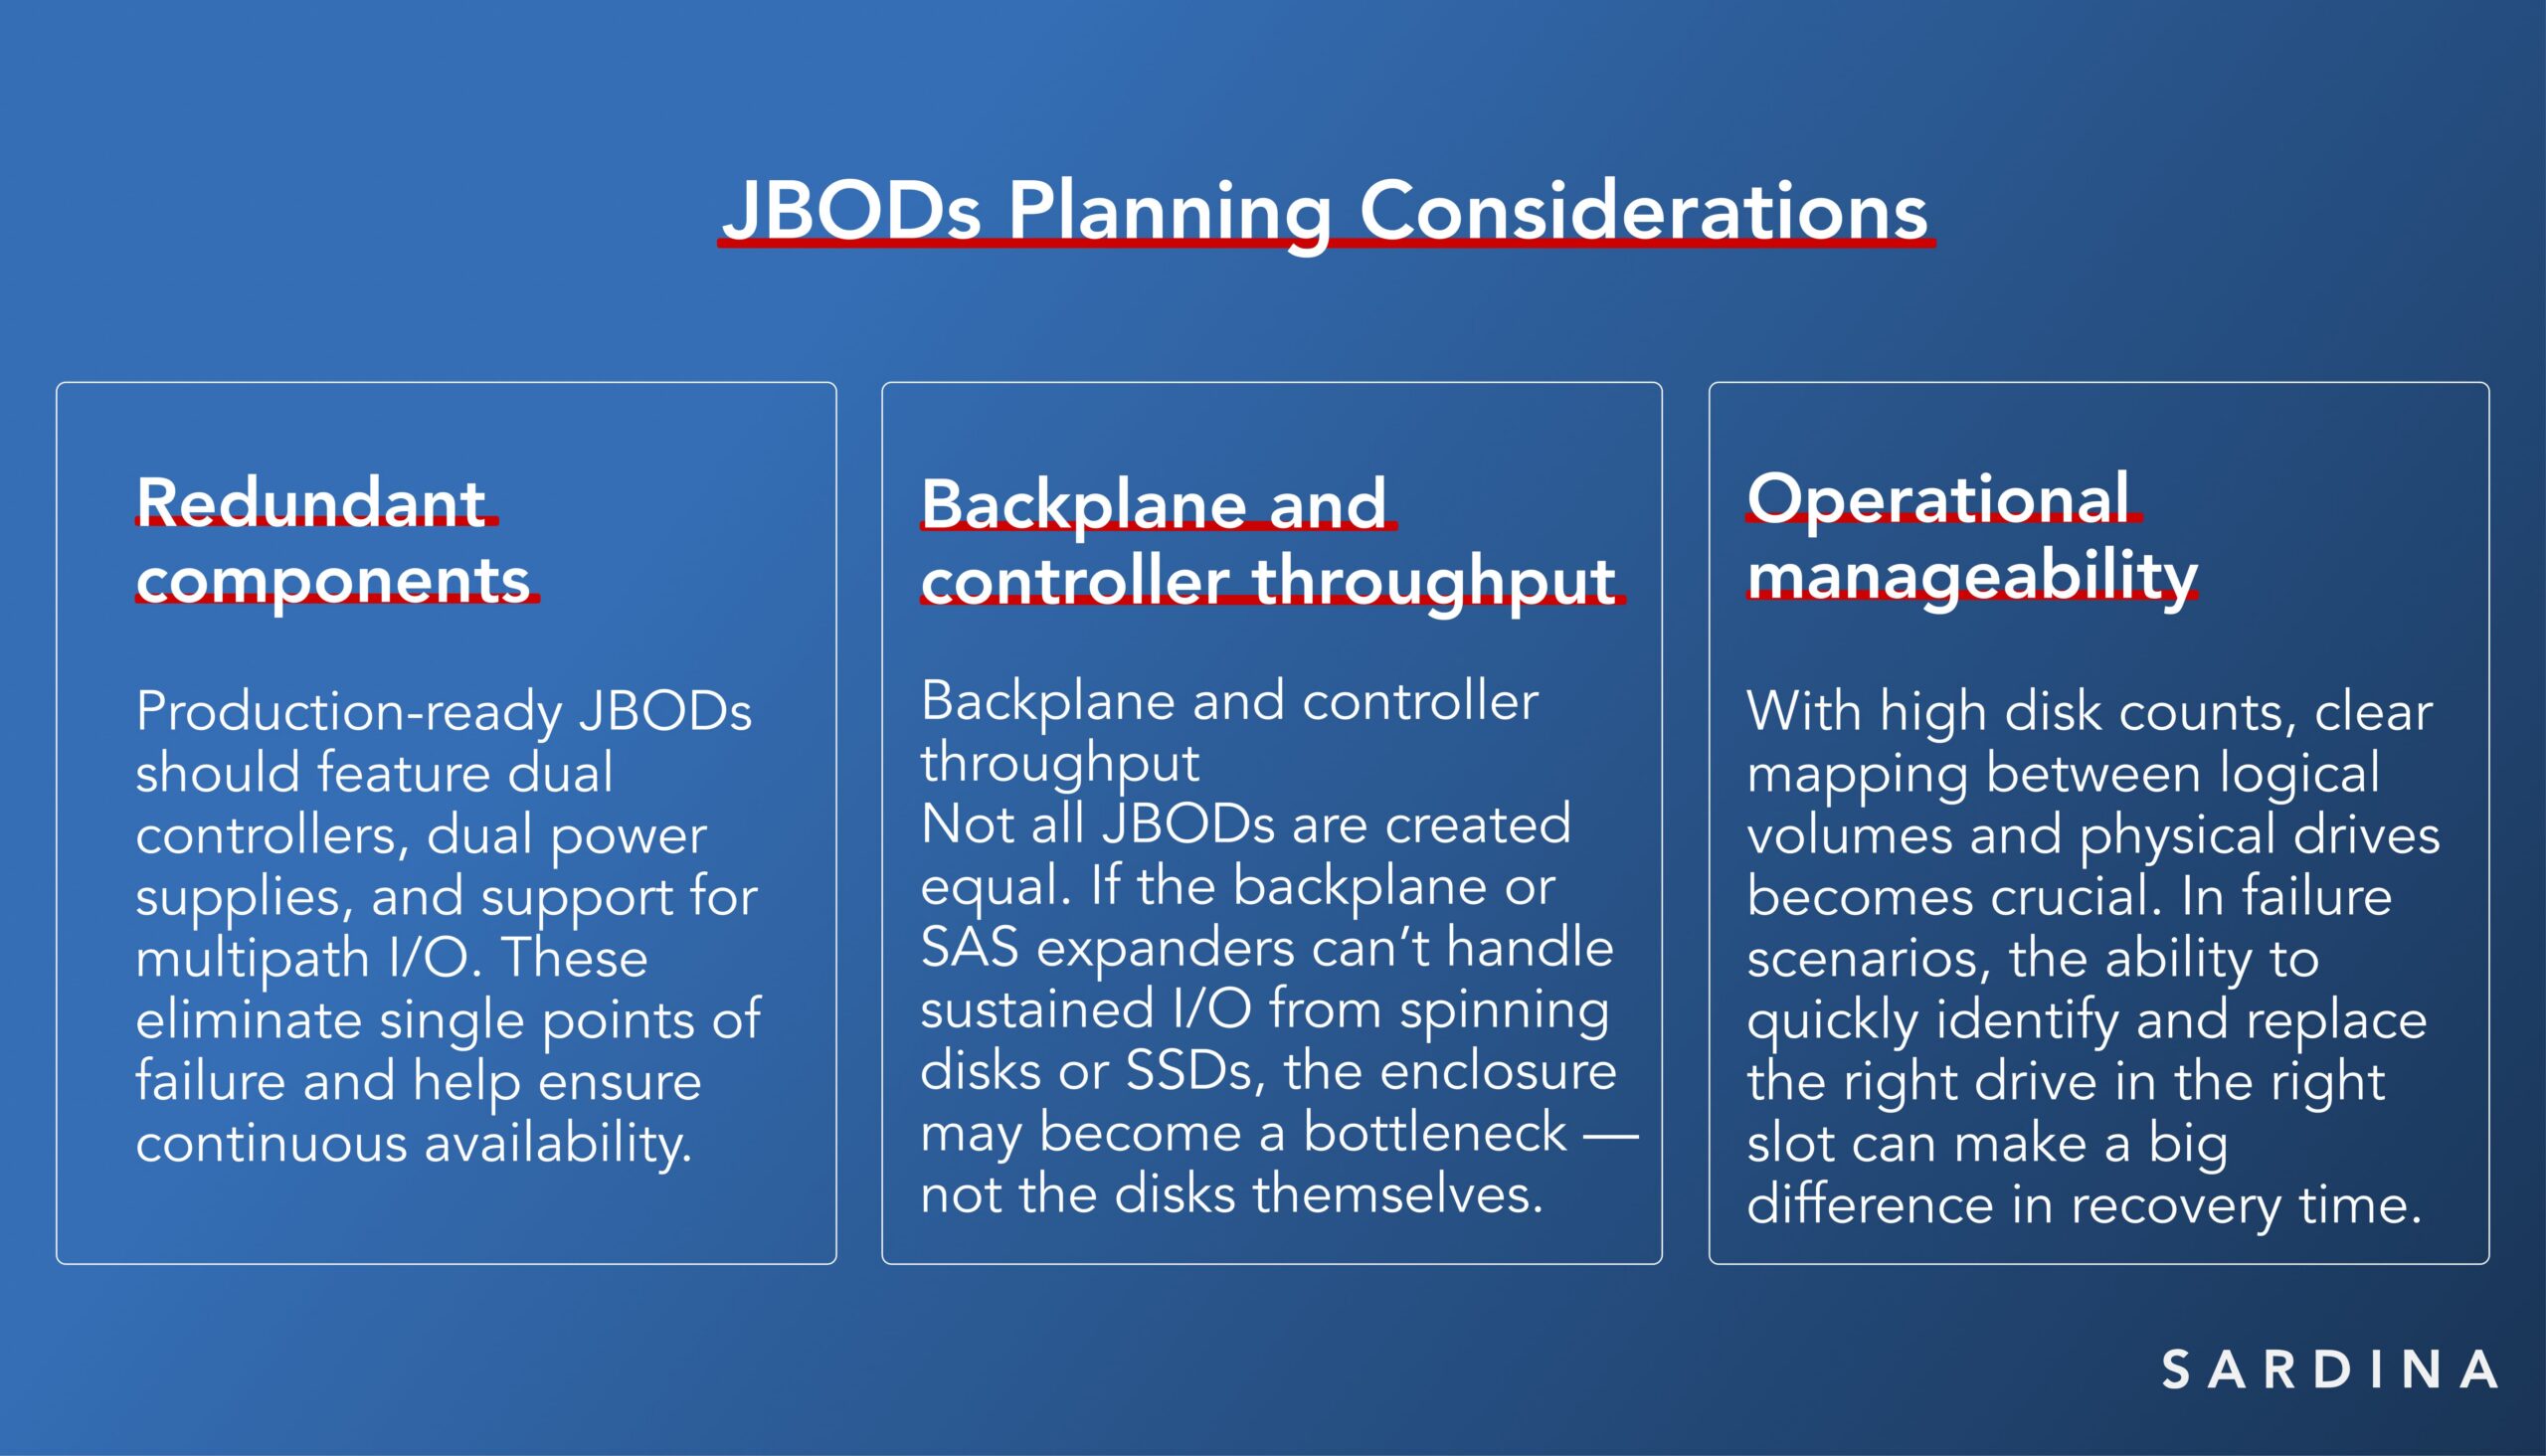
Lorsqu’ils sont correctement intégrés dans une architecture basée sur Ceph, les JBODs offrent une voie élégante et efficace vers le stockage à grande échelle, en particulier pour les charges de travail comme la sauvegarde, l’archivage, les bibliothèques multimédias et les lacs de données de recherche.
Plutôt que de les voir comme un compromis, il est plus précis de considérer les JBODs comme un outil dans la boîte à outils de l’architecte. Avec la bonne conception, les clusters basés sur JBOD peuvent offrir performance, fiabilité et rentabilité à l’échelle.
Réplication vs codage d’effacement : faire un pari à sens unique
Ceph vous donne des choix, mais certains de ces choix sont des portes à sens unique. Au centre de ce compromis se trouve le choix entre la réplication et le codage d’effacement (EC) comme politique de stockage.
- Replica-3 stocke trois copies de chaque bloc de données sur différents nœuds, offrant simplicité et hautes performances, particulièrement pour les petites opérations d’E/S.
- Le codage d’effacement divise les données en fragments de données et de parité, permettant la récupération après deux pannes tout en utilisant moins de capacité globale. EC 3+2 n’est que l’une des configurations de codage d’effacement les plus courantes que Ceph prend en charge. Selon votre tolérance au risque, vos objectifs de performance et vos cibles de capacité utilisable, des profils alternatifs comme EC 4+2, 6+3 ou 8+4 peuvent offrir un meilleur alignement.
Mais voici le hic : une fois que vous configurez un pool de stockage avec Replica-3, passer à, par exemple, EC 3+2 nécessite une interruption de service. La migration implique un processus complet de déchargement et de chargement, exportant toutes les données d’un pool et les réimportant dans un autre. Bien que des fournisseurs de services comme Sardina Systems puissent aider avec l’opération, l’interruption est inévitable.
Cela signifie que votre modèle de durabilité des données n’est pas seulement un choix technique — c’est un engagement. Si vous prévoyez de commencer avec Replica-3 et de passer plus tard à EC pour une meilleure efficacité du stockage, soyez prêt pour une fenêtre de service planifiée et les risques associés.
Budget vs. Résilience : L’équilibre de l’infrastructure
Toutes ces décisions — stratégie de réplication, taille des disques, conception des nœuds et choix du boîtier — se résument à une tension fondamentale : équilibrer le budget aujourd’hui avec la résilience de demain. Les architectes d’infrastructure doivent se demander :
- Pouvons-nous nous permettre une interruption plus tard si nous faisons des compromis maintenant ?
- Le matériel que nous achetons aujourd’hui limitera-t-il nos choix dans 12 mois ?
- Concevons-nous pour la panne ou espérons-nous simplement qu’elle ne se produira pas ?
Ce ne sont pas des questions théoriques. Elles impactent directement les délais d’approvisionnement, la planification de la capacité et, finalement, l’expérience utilisateur.
Points à retenir : ce que chaque acheteur de Ceph doit savoir
Pour de nombreuses organisations, les points à retenir sont clairs :
- Oui, vous pouvez commencer avec trois nœuds, mais planifiez soigneusement. Si vous prévoyez d’avoir besoin d’EC à l’avenir, acceptez que la migration nécessite une interruption de service et un effort opérationnel.
- Concevez avec cinq nœuds dès le départ, si possible. Même une configuration modeste de 5 nœuds EC 3+2 peut offrir une meilleure efficacité de stockage et une récupération plus facile sans augmenter significativement votre empreinte en rack.
- Ne pensez pas seulement à la capacité — pensez à la panne. Un cluster Ceph bien équilibré optimise le CPU, la RAM, la taille des disques et le domaine de défaillance.
Ceph est incroyablement flexible, mais la flexibilité ne signifie pas que vous pouvez sauter la planification architecturale. Vos décisions prises au début peuvent verrouiller des compromis qui sont coûteux ou perturbateurs à inverser plus tard. Alors avant de monter ce premier nœud, demandez-vous :
- Aurai-je besoin du codage d’effacement ?
- Quelle durée d’interruption puis-je tolérer pendant la migration ?
- À quelle vitesse je veux que la récupération se fasse ?
- Quelle densité je veux pour mes racks ?
- Ai-je besoin de m’étendre progressivement, et comment ?
Les réponses peuvent changer la façon dont vous construisez votre cluster et la fluidité avec laquelle votre infrastructure s’adapte.