
随着组织越来越多地转向软件定义基础设施,Ceph 已成为构建可扩展、弹性存储系统的首选解决方案。然而,对许多 IT 领导者来说,一个问题仍然存在:您能否从小规模开始使用 Ceph,之后再扩展,而不会遇到架构或运营方面的障碍?
这不仅仅是理论上的考虑。在当今注重预算的 IT 环境中,企业通常分阶段部署存储系统。然而,最初的选择 — 磁盘大小、存储配置和节点密度 — 往往会造成架构瓶颈,这些瓶颈的解决既痛苦又昂贵。
对许多组织而言,从小规模开始使用 Ceph 是一个实用且经济的选择。3节点集群提供了坚实的基础,并满足了使用三副本模型运行完整功能、冗余系统的最低要求,该模型在节点间存储每个对象的三个副本。
但是,虽然这种设置在短期内运行良好,但它带来了可能会使未来增长复杂化的长期权衡。随着基础设施扩展,维持性能、弹性和运营简便性的挑战会显著增加。
在本文中,我们将探讨系统架构师在规划扩展 Ceph 集群时必须考虑的关键因素:从节点数量和纠删码到硬件密度和数据恢复策略。
那么,您能从小规模开始使用 Ceph 吗?
基础设施团队最常见的问题之一是他们是否可以从最小集群开始,比如三个节点,然后再扩展。简单的答案是可以,但前提是您愿意从第一天起就以扩展的思维方式思考。
这两个选项之间的差异揭示了一个关键见解:更大的磁盘不仅意味着更多的容量,还意味着在发生故障时需要更长的恢复时间。磁盘大小是问题变得有趣且有争议的地方。
一方面,大容量磁盘(20TB 及以上)提供更好的密度和更低的每 TB 成本。另一方面,较小的驱动器(10-16TB)在某些故障场景下提供更快的恢复、更多的 OSD 和更好的性能。
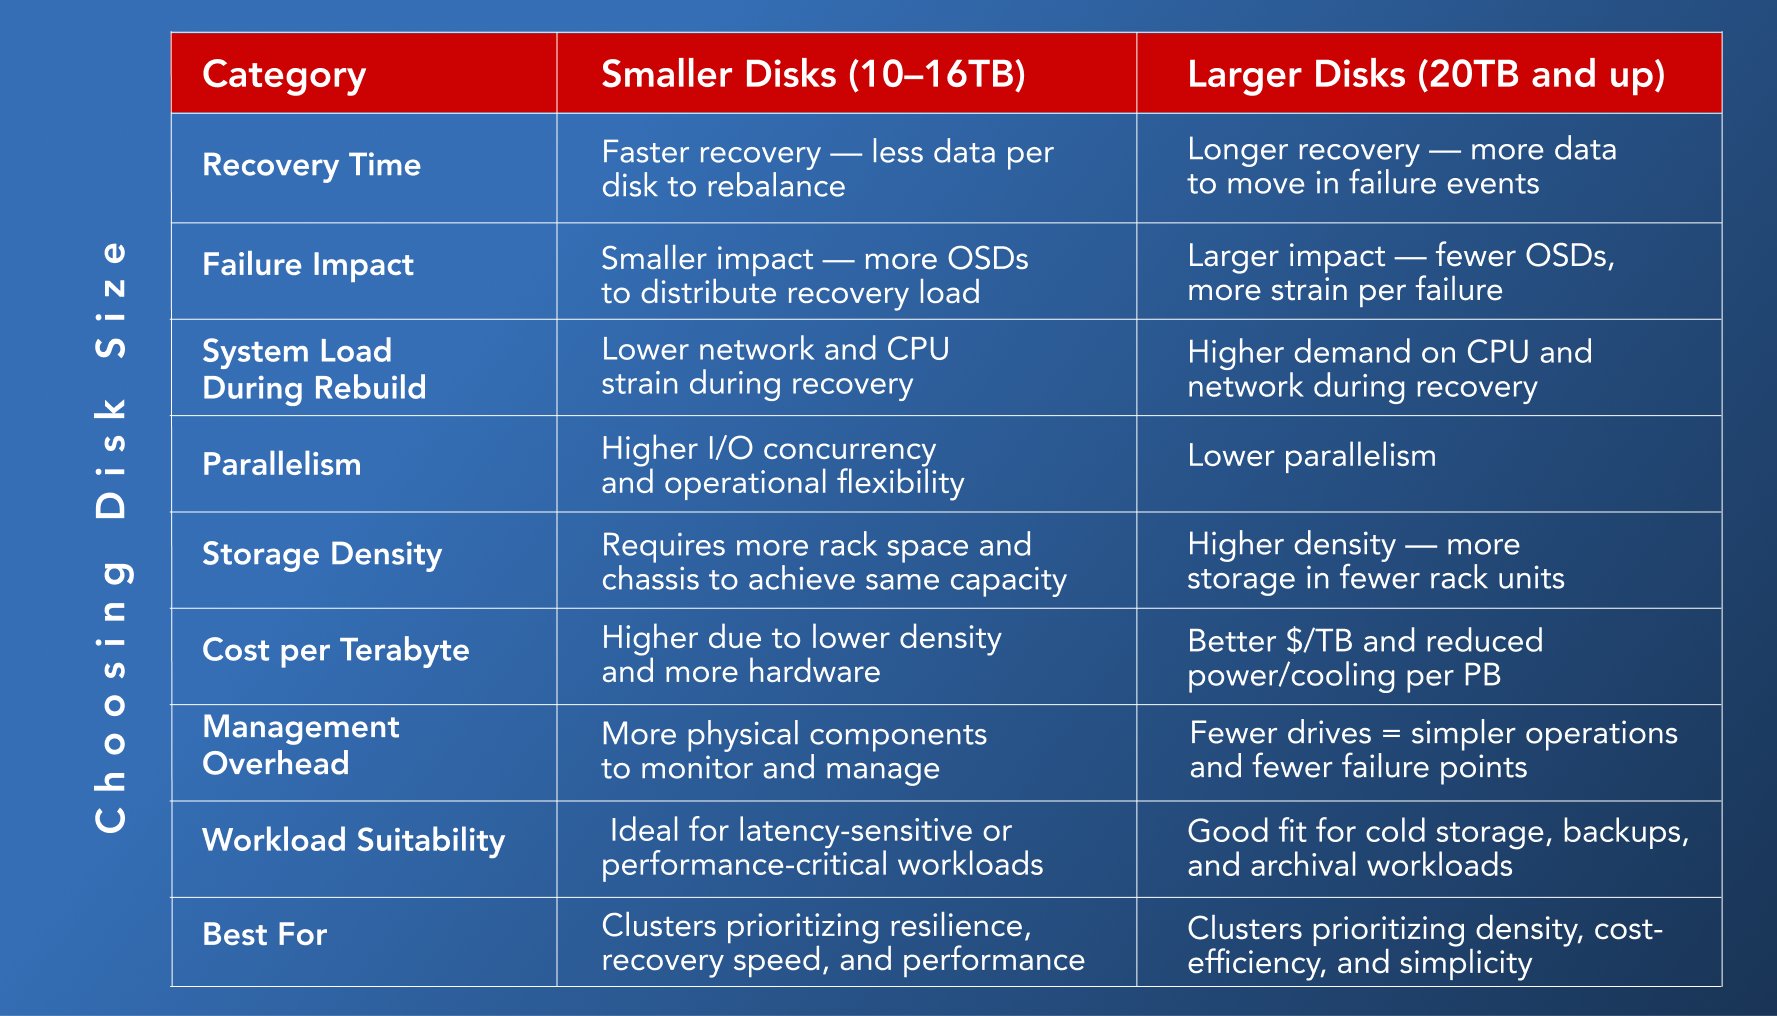
Ceph 中小型与大型磁盘的比较和使用场景
大容量磁盘会带来恢复延迟。一个 20TB 的故障驱动器可能需要数小时,甚至数天才能重新平衡,特别是在网络饱和的情况下。而且影响更大:受影响的数据更多,可用于分散负载的 OSD 更少。如果您的工作负载对延迟敏感 — 例如虚拟机存储或 Kubernetes — 大容量磁盘可能会成为恢复瓶颈。相比之下,小容量磁盘提供更优雅的性能降级和更快的恢复。
那么什么是正确的选择?如果弹性和性能是关键,小型或中型磁盘更胜一筹。它们恢复更快,扩展时痛苦更少。如果您的首要任务是密度和基础设施效率,并且您可以投资高速网络(25-100GbE)和充足的 CPU 开销,那么大容量磁盘是可行的,前提是您要谨慎管理故障域。
Ceph 中的磁盘大小:平衡密度、成本和运营考虑因素
在设计 Ceph 集群时,一个关键决策是在较少的高容量磁盘或更多的低容量磁盘之间做出选择。这两种方法都是可行的,根据您对成本效益、密度和运营可管理性的目标,各自都有其优势。
大容量磁盘 — 如 20TB 甚至 24TB 驱动器 — 的一个主要优势是它们提供更低的每 TB 成本。它们还使得在机架空间受限的环境中更容易实现高存储密度。这在构建大规模冷存储系统或规划长期容量增长时特别具有吸引力。
然而,物理密度也带来物理重量。硬盘驱动器通常重 0.5 到 0.75 千克。在装有 90 个驱动器的高密度 4U 机箱中,总重量可能超过 100 千克。一个装满这样设备的机架可能接近或超过 1,000 千克,这符合机架规格 — 但并非所有数据中心地板都能承受这种负载。
在规划高密度部署时,重要的是要考虑不仅是电源和散热,还包括地板承重能力、结构完整性和机架规格。在这些环境中,磁盘密度不仅仅是容量或成本的问题 — 它关系到基础设施的就绪性。
然而,磁盘大小也影响日常运营,特别是在规划例行清理或处理硬件故障等常规流程时。
Ceph 的清理机制,通过检查比特腐败或静默损坏来确保长期数据完整性,在使用大容量驱动器时会变得更加资源密集。由于这是一个使用 CPU 和内存的后台任务,该过程的持续时间会随磁盘容量的增加而增加。
同样,在节点或磁盘故障的情况下,使用大容量驱动器时需要重新平衡或恢复的数据量自然会更高。这本身不会造成问题,但在确定计算资源大小、规划网络吞吐量或估算恢复窗口时,这是一个需要考虑的运营因素。
举例说明:
- 一个配备 102 个 10TB HDD 磁盘的节点在故障事件中需要重新平衡 1.02PB 的原始容量。
- 同样的节点配备102 个 20TB 磁盘在故障事件中需要处理 2.04PB 的重新平衡。
这并不意味着一种方法比另一种更好 — 而是要将硬件选择与您的运营期望保持一致:
- 如果您优先考虑每 PB 成本和机架效率,大容量磁盘是一个很好的选择。
- 如果更快的重建和更低的单盘恢复影响更为重要,较小磁盘策略可能更适合您。
最终,这两种路径都是有效的,早期规划这些细微差别会带来更具弹性、更高效的 Ceph 部署。
JBOD:经济高效、可扩展,但不是万能钥匙
在不超出预算的情况下扩展存储的竞赛中,JBOD — 简单磁盘组 — 已成为一个诱人的选择。在许多情况下,这确实是合理的。
JBOD 是一个装满独立驱动器的磁盘机柜,这些驱动器并未组成 RAID 阵列。相反,它们作为独立设备暴露给主机操作系统或软件定义存储层(如 Ceph、ZFS 或软件 RAID)。这意味着冗余、容错和恢复都在软件中实现,而不是在硬件中。
在 Ceph 部署中,JBOD 通常用于扩展它们直接连接的服务器的存储容量 — 而不是作为独立设备。这种模式很好地符合 Ceph 的架构,其中服务器提供逻辑,而 JBOD 提供原始磁盘容量。这不仅仅是为了节省成本 — 它是关于使用可容纳大量驱动器的机柜来高效、紧凑地扩展存储。
对于许多构建 Ceph 或其他对象存储系统的团队来说,JBOD 是有意义的。 您可以从部分填充的机柜开始,根据需要添加驱动器。无需预先过度配置硬件。这是一种减少前期投资的模式,直到存储需求证明投资是合理的。
当然,与任何基础设施组件一样,要充分利用JBOD需要周密的规划。必须内置冗余、可靠性和可恢复性。
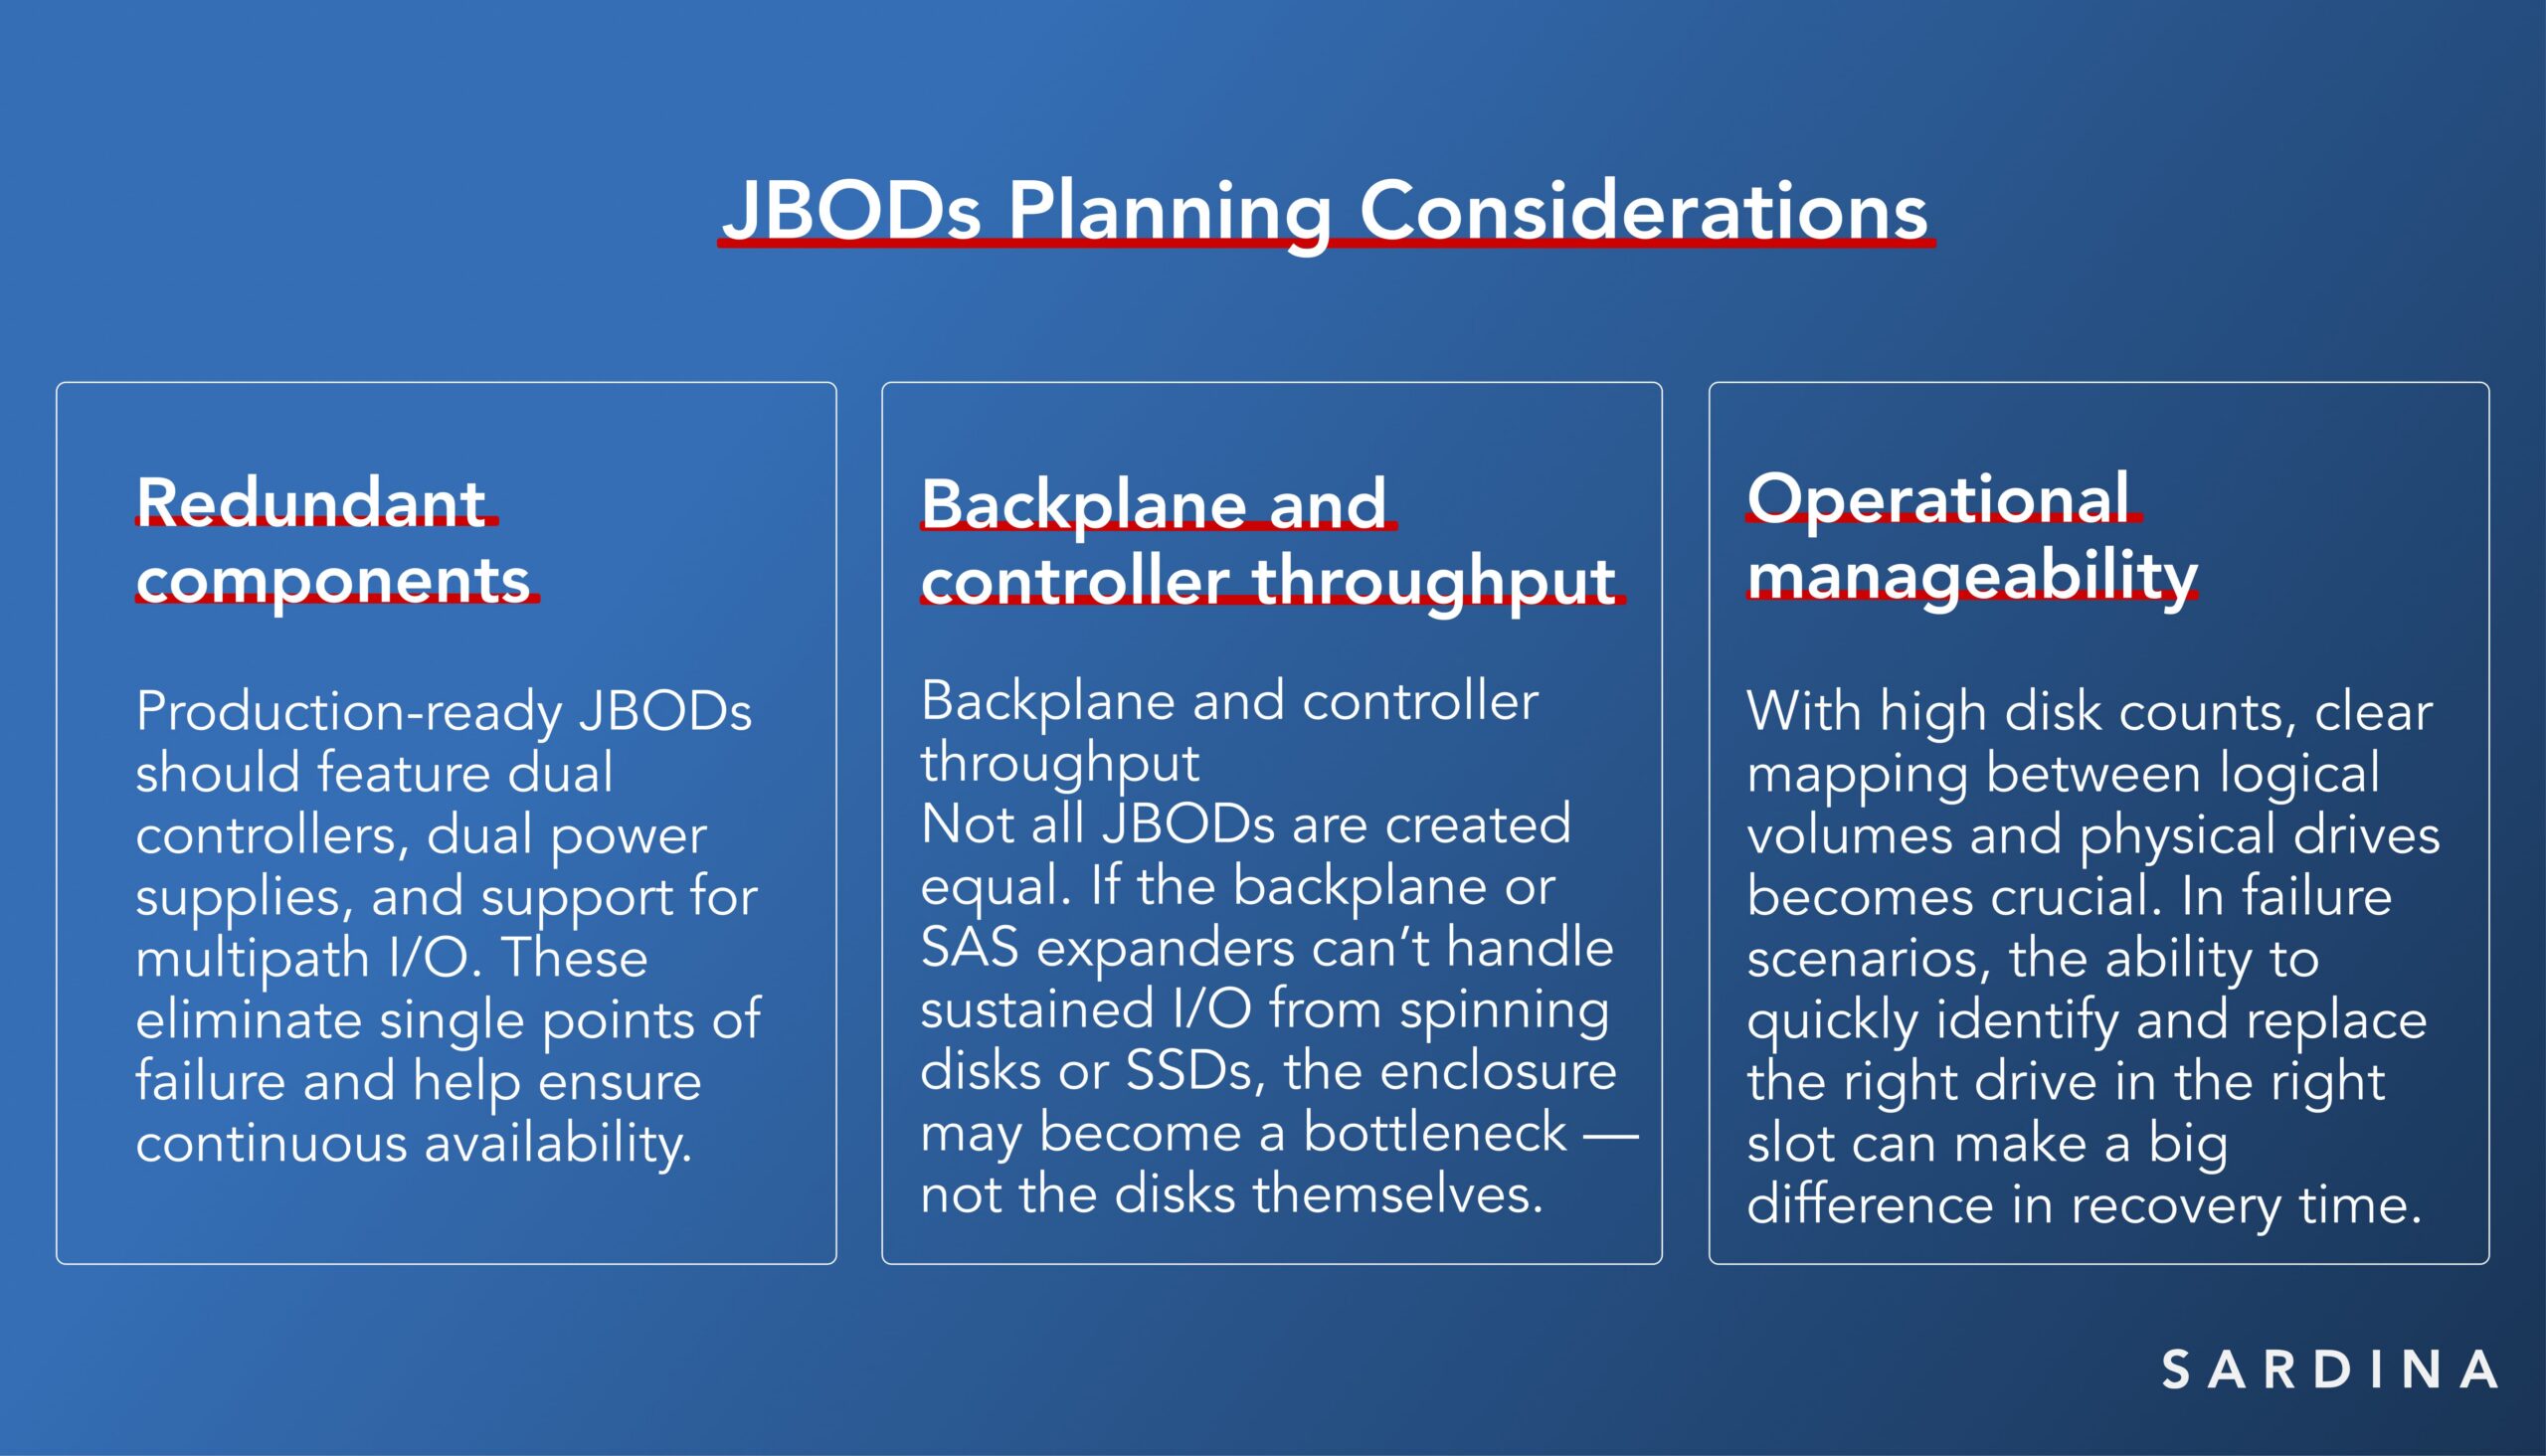
当正确集成到基于 Ceph 的架构中时,JBOD为大规模存储提供了一个优雅、高效的路径,特别是对于备份、归档、媒体库和研究数据湖等工作负载。
与其将它们视为妥协,不如将 JBOD 视为架构师工具箱中的工具。通过正确的设计,基于 JBOD 的集群可以在规模上提供性能、可靠性和成本效益。
副本与纠删码:做出单向选择
Ceph 给您选择,但有些选择是单向的。在这种权衡的核心在于选择复制和纠删码(EC)作为存储策略。
- 三副本在不同节点上存储每个数据块的三个副本,为小型 I/O 操作提供简单性和高性能。
- 纠删码将数据分割成数据块和奇偶校验块,允许从任何两次故障中恢复,同时使用更少的总体容量。EC 3+2 只是 Ceph 支持的最常见的纠删码配置之一。根据您的风险承受能力、性能目标和可用容量目标,EC 4+2、6+3 或 8+4 等替代配置可能提供更好的匹配。
但这里有个问题:一旦您使用三副本设置存储池,切换到 EC 3+2 需要停机。迁移涉及
这意味着您的数据持久性模型不仅仅是技术选择 — 它是一种承诺。如果您计划从三副本开始,之后切换到 EC 以获得更好的存储效率,请准备好计划服务窗口和相关风险。
预算与弹性:基础设施的平衡艺术
所有这些决策 — 复制策略、磁盘大小、节点设计和机柜选择 — 归结为一个核心矛盾:平衡当前预算与未来弹性。基础设施架构师必须问:
- 如果我们现在削减成本,我们以后能否承受停机时间?
- 我们今天购买的硬件是否会限制我们 12 个月后的选择?
- 我们是在为故障设计还是仅仅希望它不会发生?
这些不是理论问题。它们直接影响采购时间表、容量规划,最终影响用户体验。
要点:每个 Ceph 购买者都应该知道的事
对许多组织来说,要点很明确:
- 是的,您可以从三个节点开始,但要仔细规划。 如果您预计将来需要 EC,请接受迁移需要停机和运营努力的事实。
- 如果可能,从一开始就设计五个节点。 即使是一个适度的 5 节点 EC 3+2 设置也可以提供更好的存储效率和更容易的恢复,而不会显著增加机架占用空间。
- 不要只考虑容量 — 要考虑故障。 一个平衡良好的 Ceph 集群优化了 CPU、RAM、磁盘大小和故障域。
Ceph 非常灵活,但灵活性并不意味着您可以跳过架构规划。您在开始时做出的决定可能会锁定以后昂贵或破坏性的权衡。因此,在您安装第一个节点之前,请问问自己:
- 我是否需要纠删码?
- 在迁移期间我能容忍多少停机时间?
- 我希望恢复速度有多快?
- 我希望机架密度有多高?
- 我是否需要逐步扩展,如何扩展?
这些答案可能会改变您构建集群的方式和基础设施扩展的顺畅程度。