
Seiring dengan semakin banyaknya organisasi yang beralih ke infrastruktur yang ditentukan perangkat lunak, Ceph telah muncul sebagai solusi pilihan untuk membangun sistem penyimpanan yang skalabel dan tangguh. Namun, bagi banyak pemimpin TI, pertanyaan tetap ada: Bisakah Anda memulai dengan Ceph dalam skala kecil dan memperluasnya nanti tanpa menghadapi hambatan arsitektur atau operasional?
Ini lebih dari sekadar pertimbangan teoretis. Dalam lingkungan TI yang sadar anggaran saat ini, perusahaan sering kali menerapkan sistem penyimpanan secara bertahap. Namun, pilihan awal — ukuran disk, profil penyimpanan, dan kepadatan node — sering kali menciptakan hambatan arsitektur yang sulit dan mahal untuk diatasi.
Bagi banyak organisasi, memulai dengan Ceph dalam skala kecil adalah pilihan yang praktis dan hemat biaya. Sebuah klaster 3-node menawarkan fondasi yang kokoh dan memenuhi persyaratan minimum untuk menjalankan sistem yang berfungsi penuh dan redundan menggunakan model Replica-3, yang menyimpan tiga salinan setiap objek di seluruh node.
Namun, meskipun pengaturan ini berfungsi dengan baik dalam jangka pendek, ia datang dengan pertukaran jangka panjang yang dapat mempersulit pertumbuhan di masa depan. Seiring dengan berkembangnya infrastruktur, tantangan untuk mempertahankan kinerja, ketahanan, dan kesederhanaan operasional meningkat secara signifikan.
Dalam artikel ini, kami akan membahas pertimbangan utama yang harus diperhitungkan oleh arsitek sistem saat merencanakan penskalaan klaster Ceph: mulai dari jumlah node dan pengodean penghapusan hingga kepadatan perangkat keras dan strategi pemulihan data.
Jadi, bisakah Anda memulai Ceph dalam skala kecil?
Salah satu pertanyaan paling umum dari tim infrastruktur adalah apakah mereka dapat memulai dengan klaster minimal, seperti tiga node, dan memperluasnya nanti. Jawaban singkatnya adalah ya, tetapi hanya jika Anda bersedia berpikir seperti penskalaan ke atas sejak hari pertama.
Perbedaan antara kedua opsi ini mengungkapkan wawasan utama: disk yang lebih besar tidak hanya berarti kapasitas yang lebih banyak, tetapi juga berarti waktu pemulihan yang lebih lama jika terjadi kegagalan. Ukuran disk adalah tempat hal-hal menjadi menarik dan memecah belah.
Di satu sisi, disk yang lebih besar (misalnya 20TB ke atas) menawarkan kepadatan yang lebih baik dan biaya per terabyte yang lebih rendah. Di sisi lain, drive yang lebih kecil (10–16TB) menawarkan pemulihan yang lebih cepat, lebih banyak OSD, dan kinerja yang lebih baik dalam skenario kegagalan tertentu.
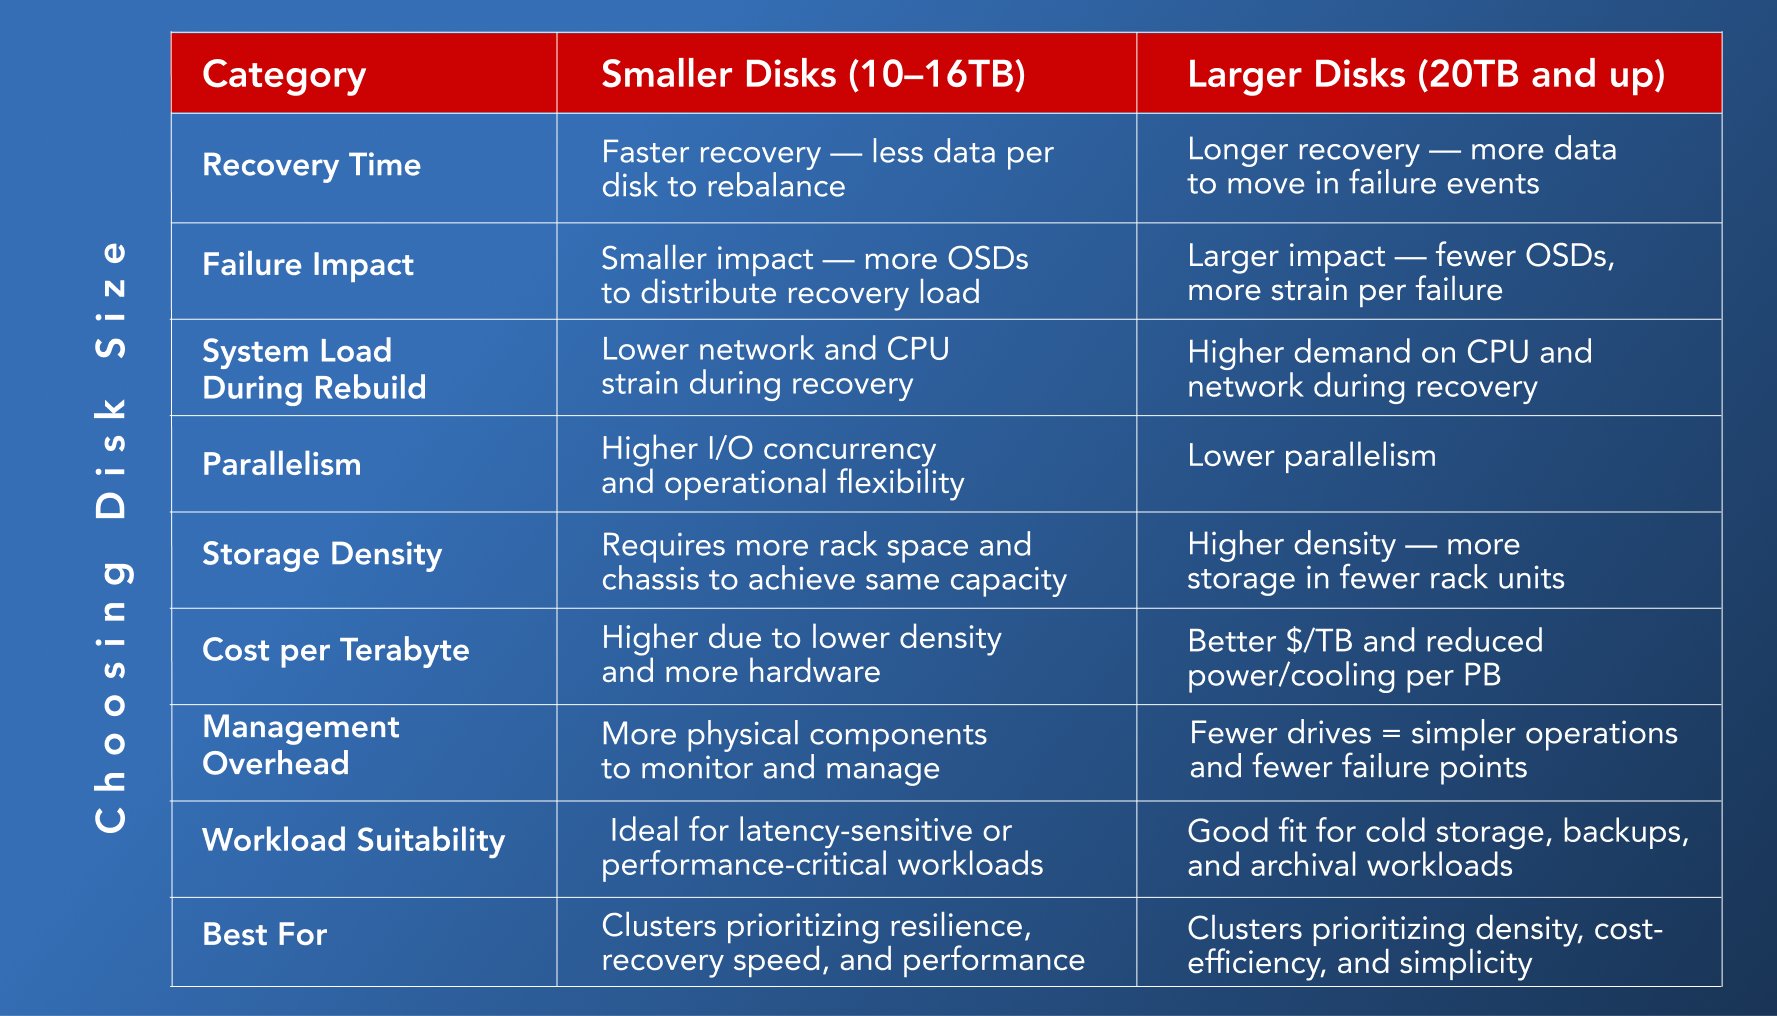
Disk Kecil vs. Besar di Ceph: Perbandingan dan Kasus Penggunaan
Disk yang lebih besar datang dengan penundaan pemulihan. Drive 20TB yang gagal dapat memakan waktu berjam-jam, bahkan berhari-hari untuk menyeimbangkan kembali, terutama pada jaringan yang jenuh. Dan dampaknya lebih besar: lebih banyak data yang terpengaruh, lebih sedikit OSD untuk menyebarkan beban. Jika beban kerja Anda sensitif terhadap latensi — misalnya, penyimpanan VM atau Kubernetes — disk besar dapat menjadi hambatan pemulihan Anda. Disk yang lebih kecil, di sisi lain, menawarkan degradasi yang anggun dan pemulihan yang lebih cepat.
Jadi, apa pilihan yang tepat? Jika ketahanan dan kinerja adalah kunci, disk yang lebih kecil atau berukuran sedang adalah pemenangnya. Mereka pulih lebih cepat dan skalanya lebih mudah. Jika prioritas utama Anda adalah kepadatan dan efisiensi infrastruktur, dan Anda dapat berinvestasi pada jaringan cepat (25–100GbE) dan overhead CPU yang memadai, maka disk yang lebih besar dapat digunakan, asalkan Anda mengelola domain kegagalan dengan hati-hati.
Ukuran Disk di Ceph: Menyeimbangkan Kepadatan, Biaya, dan Pertimbangan Operasional
Saat merancang klaster Ceph, salah satu keputusan utama adalah memilih antara disk berkapasitas tinggi yang lebih sedikit atau disk berkapasitas rendah yang lebih banyak. Kedua pendekatan ini layak, dan masing-masing membawa keunggulannya sendiri tergantung pada tujuan Anda untuk efisiensi biaya, kepadatan, dan pengelolaan operasional.
Manfaat utama dari disk yang lebih besar — seperti drive 20TB atau bahkan 24TB — adalah bahwa mereka menawarkan biaya per terabyte yang lebih rendah. Mereka juga mempermudah pencapaian kepadatan penyimpanan yang tinggi, terutama di lingkungan yang terbatas rak. Ini bisa sangat menarik saat membangun sistem penyimpanan dingin skala besar atau saat merencanakan pertumbuhan kapasitas jangka panjang.
Namun, kepadatan fisik juga membawa beban fisik. HDD biasanya memiliki berat antara 0,5 hingga 0,75 kg masing-masing. Dalam sasis 4U berdensitas tinggi yang diisi dengan 90 drive, berat total dapat melebihi 100 kg per unit. Rak penuh yang dimuat dengan beberapa unit semacam itu dapat mendekati atau melebihi 1.000 kg, yang sesuai dengan spesifikasi rak — tetapi tidak semua lantai pusat data dinilai mampu menangani beban tersebut.
Saat merencanakan penerapan padat, penting untuk mempertimbangkan tidak hanya daya dan pendinginan, tetapi juga kapasitas beban lantai, integritas struktural, dan spesifikasi rak. Di lingkungan ini, kepadatan disk bukan hanya masalah kapasitas atau biaya — ini adalah masalah kesiapan infrastruktur.
Namun, ukuran disk juga menjadi faktor dalam operasi sehari-hari, terutama saat merencanakan proses rutin seperti scrubbing atau penanganan kegagalan perangkat keras.
Mekanisme scrubbing Ceph, yang memastikan integritas data jangka panjang dengan memeriksa kerusakan bit atau korupsi senyap, menjadi lebih intensif sumber daya dengan drive yang lebih besar. Karena ini adalah tugas latar belakang yang menggunakan CPU dan memori, durasi prosesnya berskala dengan kapasitas disk.
Demikian pula, jika terjadi kegagalan node atau disk, jumlah data yang perlu diseimbangkan kembali atau dipulihkan secara alami akan lebih tinggi saat menggunakan drive yang lebih besar. Ini bukan masalah itu sendiri, tetapi ini adalah pertimbangan operasional yang perlu diperhitungkan saat menentukan ukuran sumber daya komputasi, merencanakan throughput jaringan, atau memperkirakan jendela pemulihan.
Sebagai ilustrasi:
- Sebuah node dengan disk HDD 102x10TB akan memiliki kapasitas mentah 1,02PB untuk diseimbangkan kembali dalam peristiwa kegagalan.
- Node yang sama dengan disk 102 x 20TB akan memerlukan penanganan 2,04PB untuk diseimbangkan kembali dalam peristiwa kegagalan.
Ini tidak berarti satu pendekatan lebih baik dari yang lain — melainkan, ini tentang menyelaraskan pilihan perangkat keras dengan ekspektasi operasional Anda:
- Jika Anda memprioritaskan biaya per PB dan efisiensi rak, disk besar adalah pilihan yang kuat.
- Jika pembangunan kembali yang lebih cepat dan dampak pemulihan per-disk yang lebih rendah lebih penting, strategi disk yang lebih kecil mungkin lebih cocok untuk Anda.
Pada akhirnya, kedua jalur tersebut valid, dan perencanaan untuk nuansa ini sejak awal mengarah pada penerapan Ceph yang lebih tangguh dan efisien.
JBOD: Hemat Biaya, Skalabel, dan Bukan Kode Curang
Dalam upaya untuk menskalakan penyimpanan tanpa menghabiskan anggaran, JBOD — Just a Bunch of Disks — telah menjadi pilihan yang menarik. Dan dalam banyak kasus, memang demikian.
JBOD adalah wadah disk yang diisi dengan drive individual yang tidak dikelompokkan ke dalam array RAID. Sebaliknya, mereka diekspos ke OS host atau lapisan penyimpanan yang ditentukan perangkat lunak (seperti Ceph, ZFS, atau RAID perangkat lunak) sebagai perangkat independen. Itu berarti redundansi, toleransi kesalahan, dan pemulihan berada di perangkat lunak, bukan di perangkat keras.
Dalam penerapan Ceph, JBOD biasanya digunakan untuk memperluas kapasitas penyimpanan server tempat mereka terhubung langsung — bukan sebagai peralatan mandiri. Model ini selaras dengan arsitektur Ceph, di mana server menyediakan logika dan JBOD menyediakan kapasitas disk mentah. Ini bukan hanya tentang menghemat biaya — ini tentang memperluas penyimpanan secara efisien dan ringkas, menggunakan wadah yang dapat menampung sejumlah besar drive.
Bagi banyak tim yang membangun Ceph atau sistem penyimpanan objek lainnya, JBOD masuk akal. Anda dapat memulai dengan wadah yang terisi sebagian dan menambahkan drive sesuai kebutuhan. Tidak perlu melakukan over-provisioning perangkat keras di awal. Ini adalah model yang mengurangi CapEx dan menunda investasi penuh hingga permintaan penyimpanan membenarkannya.
Tentu saja, seperti halnya komponen infrastruktur lainnya, mendapatkan hasil maksimal dari JBOD memerlukan perencanaan yang cermat. Redundansi, keandalan, dan kemampuan pemulihan harus dibangun di dalamnya.
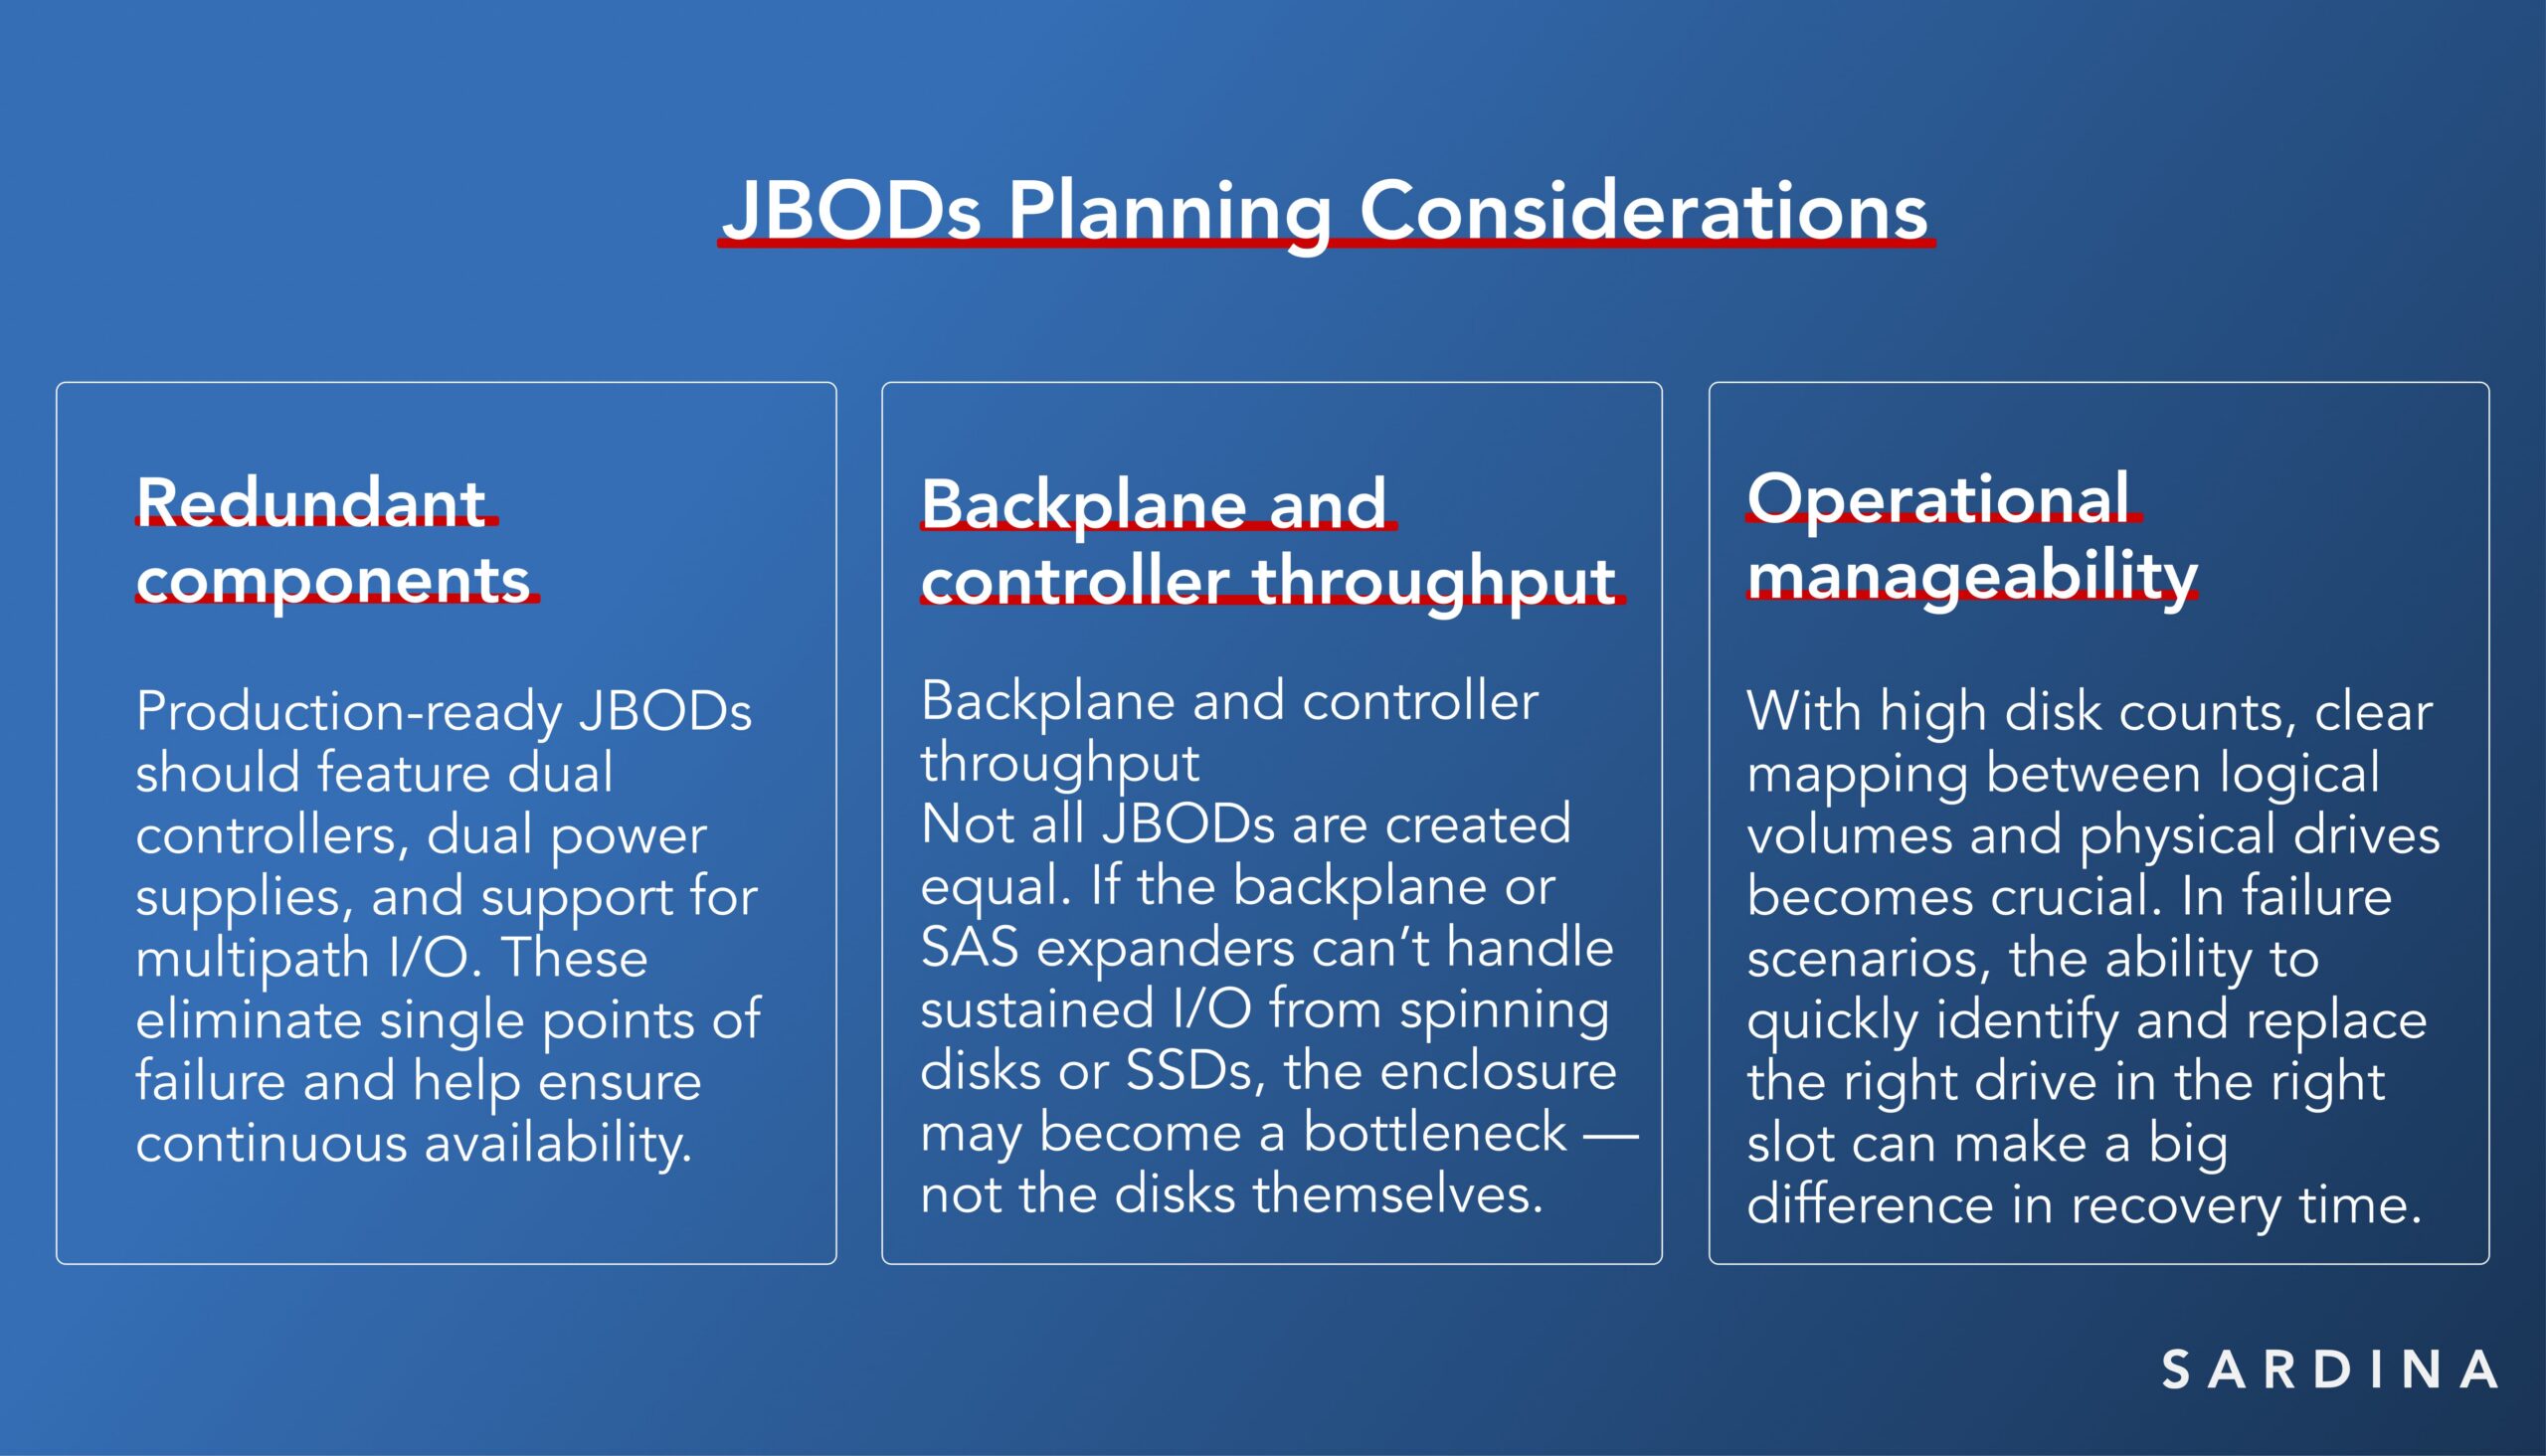
Ketika diintegrasikan dengan benar ke dalam arsitektur berbasis Ceph, JBOD menawarkan jalur yang elegan dan efisien menuju penyimpanan skala besar, terutama untuk beban kerja seperti pencadangan, pengarsipan, pustaka media, dan data lake penelitian.
Daripada melihatnya sebagai kompromi, lebih akurat untuk melihat JBOD sebagai alat dalam perangkat arsitek. Dengan desain yang tepat, klaster berbasis JBOD dapat memberikan kinerja, keandalan, dan efisiensi biaya dalam skala besar.
Replika vs Pengodean Penghapusan: Membuat Taruhan Satu Arah
Ceph memberi Anda pilihan, tetapi beberapa pilihan tersebut adalah pintu satu arah. Di pusat pertukaran ini terletak pilihan antara replikasi dan pengodean penghapusan (EC) sebagai kebijakan penyimpanan.
- Replica-3 menyimpan tiga salinan setiap blok data di seluruh node yang berbeda, menawarkan kesederhanaan dan kinerja tinggi, terutama untuk operasi I/O kecil.
- Pengodean Penghapusan membagi data menjadi potongan data dan paritas, memungkinkan pemulihan dari dua kegagalan apa pun sambil menggunakan kapasitas keseluruhan yang lebih sedikit. EC 3+2 hanyalah salah satu konfigurasi pengodean penghapusan paling umum yang didukung Ceph. Tergantung pada toleransi risiko, tujuan kinerja, dan target kapasitas yang dapat digunakan, profil alternatif seperti EC 4+2, 6+3, atau 8+4 mungkin menawarkan keselarasan yang lebih baik.
Namun, inilah masalahnya: setelah Anda menyiapkan kumpulan penyimpanan dengan Replica-3, beralih ke, misalnya, EC 3+2 memerlukan waktu henti. Migrasi melibatkan proses
Ini berarti model ketahanan data Anda bukan hanya pilihan teknis — ini adalah komitmen. Jika Anda berencana untuk memulai dengan Replica-3 dan kemudian beralih ke EC untuk efisiensi penyimpanan yang lebih baik, bersiaplah untuk jendela layanan yang direncanakan dan risiko terkait.
Anggaran vs. Ketahanan: Tindakan Penyeimbangan Infrastruktur
Semua keputusan ini — strategi replikasi, ukuran disk, desain node, dan pilihan wadah — bermuara pada satu ketegangan inti: menyeimbangkan anggaran hari ini dengan ketahanan besok. Arsitek infrastruktur harus bertanya:
- Bisakah kita menanggung waktu henti nanti jika kita menghemat sekarang?
- Akankah perangkat keras yang kita beli hari ini membatasi pilihan kita dalam 12 bulan?
- Apakah kita merancang untuk kegagalan atau hanya berharap itu tidak terjadi?
Ini bukan pertanyaan teoretis. Ini secara langsung memengaruhi jadwal pengadaan, perencanaan kapasitas, dan pada akhirnya, pengalaman pengguna.
Poin-poin Penting: Apa yang Harus Diketahui Setiap Pembeli Ceph
Bagi banyak organisasi, poin-poin pentingnya jelas:
- Ya, Anda bisa memulai dengan tiga node, tetapi rencanakan dengan cermat. Jika Anda mengantisipasi kebutuhan EC di masa mendatang, terimalah bahwa migrasi memerlukan waktu henti dan upaya operasional.
- Rancang dengan lima node sejak awal, jika memungkinkan. Bahkan pengaturan EC 3+2 5-node yang sederhana dapat menawarkan efisiensi penyimpanan yang lebih baik dan pemulihan yang lebih mudah tanpa meningkatkan jejak rak Anda secara signifikan.
- Jangan hanya memikirkan kapasitas — pikirkan tentang kegagalan. Klaster Ceph yang seimbang mengoptimalkan CPU, RAM, ukuran disk, dan domain kegagalan.
Ceph sangat fleksibel, tetapi fleksibilitas tidak berarti Anda dapat melewatkan perencanaan arsitektur. Keputusan yang Anda buat di awal dapat mengunci pertukaran yang mahal atau mengganggu untuk dibalik nanti. Jadi sebelum Anda memasang node pertama itu, tanyakan pada diri Anda:
- Apakah saya akan membutuhkan pengodean penghapusan?
- Berapa banyak waktu henti yang dapat saya toleransi selama migrasi?
- Seberapa cepat saya ingin pemulihan?
- Seberapa padat saya ingin rak saya?
- Apakah saya perlu memperluas secara bertahap, dan bagaimana caranya?
Jawabannya dapat mengubah cara Anda membangun klaster dan seberapa lancar infrastruktur Anda berskala.